<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" xml:lang="en"><generator uri="https://jekyllrb.com/" version="4.4.1">Jekyll</generator><link href="https://lefdrida.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://lefdrida.github.io/" rel="alternate" type="text/html" hreflang="en" /><updated>2026-10-07T22:57:15+00:00</updated><id>https://lefdrida.github.io/feed.xml</id><title type="html">Rida Lefdali</title><subtitle>Rida Lefdali — data scientist working on machine learning, LLMs and computer vision. Technical writing on transformers, retrieval-augmented generation and deep learning.</subtitle><author><name>Rida Lefdali</name></author><entry><title type="html">RNN and Hierarchical Attention Network</title><link href="https://lefdrida.github.io/posts/2025/HAN_blog/" rel="alternate" type="text/html" title="RNN and Hierarchical Attention Network" /><published>2025-03-20T15:12:00+00:00</published><updated>2025-03-20T15:12:00+00:00</updated><id>https://lefdrida.github.io/posts/2025/HAN_blog</id><content type="html" xml:base="https://lefdrida.github.io/posts/2025/HAN_blog/"><![CDATA[<p>In this posts, we will try to get familiar with RNN, self-attention and HAN architectures. 
Data exists in many types such as tabular, imgaes, graph, texts etc. Sequential data is data arranged in an ordered sequence. It could be ordered by time, e.g time series, or by position, e.g text. generally, we model the sequence as follows: \((x_{1}, x_{2}, …, x_{T})\), where \((x_{i})\) could be a word in case of a text, a real value in case of a time series etc… .</p>

<p>Recurrent Neural Network are very suitable to work with sequential data and make prediction using this kind of data. In this posts, we will Talk about RNNs and some of its variants, GRU and BiGRU and HAN architecture which uses self attention with BidirGRU. Also, we will see an application of HAN to classify IMDB movie reviews. 
Other interesting kind of RNN such as LSTM will be covered later in another post.</p>

<h2 id="recurrent-neural-network---rnn">Recurrent Neural Network - RNN</h2>

<p>An RNN takes as input a sequence \((x_{1}, x_{2}, …, x_{T})\) and outputs a sequence of hidden states (or representations) \((h_{1}, h_{2}, …, h_{T})\) which are often called <em>annnotations</em>. 
At each time step \(t\), the RNN unit takes as input \(x_{t}\) and the previous hidden state \(h_{t-1}\) to compute the hidden state as follows:</p>

\[h_{t} = \sigma (U x_{t} + W h_{t-1} +  b)\]

<p>The hidden representations are used then to make a prediction. This makes RNNs relays only on past information and no future information are used:</p>

\[y_{t} = \sigma (W_{y} h_{t} + b')\]

<p>RNNs can process input of any size and the model size remains independent of the input size as the weight are share across time. But they are computationally slow and they have difficulties to learn long term dependancies. So, they suffers from vanishing/exploding gradient because of multiplicative gradient that can be exponentially decreasing or increasing with respect to the number of layers.</p>

<h2 id="gated-recurrent-unit---gru">Gated Recurrent Unit - GRU</h2>

<p>GRU are an RNN that deals with vanishing gradient problem through using specific gates. In GRU we have two gates, reset (relevance) gate and update gate, defined as follows:</p>

<p>\begin{equation}r_{t} = \sigma (U_{r} x_{t} + W_{r} h_{t-1} + b_{r})\end{equation}</p>

<p>\begin{equation}z_{t} = \sigma (U_{z} x_{t} + W_{z} h_{t-1} + b_{z})\end{equation}</p>

<p>The reset gate determines how much information should be discarder from previous time steps stored in \(h_{t-1}\).</p>

<p>So we compute a candidate hidden state using this reset gates as follows :</p>

\[\hat{h}_t = tanh(U_{h} x_{t} + W_{h}(r_{t} \circ h_{t-1}) + b_{h})\]

<p>This candidates hidden states is used along with the previous hidden states to obtain the final hidden state by linearly interpolating them using the update gates:</p>

\[h_t= (1 - z_{t}) \circ h_{t-1} + z_{t} \circ \hat{h}_t\]

<h2 id="bidirectional-gru">Bidirectional GRU</h2>

<p>Bidirectional GRU is GRU variant that consider hidden state from previous and future steps to predict the current hidden state:</p>

\[h_t^{+}= gru(x_{t}; h_{t+1})\]

\[h_t^{-}= gru(x_{t}; h_{t-1})\]

\[h_t= h_t^{-} \circ h_t^{+}\]

<p>Bidirectional GRU can be implemented easily using <em>Pytorch</em></p>
<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">torch</span>
<span class="n">gru</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">GRU</span><span class="p">(</span>
            <span class="n">input_size</span><span class="o">=</span><span class="n">d</span><span class="p">,</span> <span class="c1"># The size of the input
</span>            <span class="n">hidden_size</span><span class="o">=</span><span class="n">n_units</span><span class="p">,</span> <span class="c1"># The size of the hidden state 
</span>            <span class="n">num_layers</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span>
            <span class="n">bias</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
            <span class="n">batch_first</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
            <span class="n">bidirectional</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
        <span class="p">)</span>
</code></pre></div></div>
<p>The <em>bidirectional</em> argument is set to True to specify a biderctional GRU. If it is set to False then we have normal GRU</p>

<h2 id="self-attention">Self Attention</h2>

<p>The attention mechanism was developed in encoder-decoder architecture for NMT context and then used for other context. The attention also used in encoder only settings and it is called self or inner attention. Self attention is the core component of transformers.</p>

<p>The idea behind attention is to use for prediction a weighted sum, where all the weights are determined using trainable parameters, of the all hidden states \((h_{1}, h_{2}, …, h_{T})\) rather than using the last hidden state which is prone to information loss.</p>

<p>The hidden states are passed to a dense layer (eq 3). The alignment coefficient are computed by comparing the output of the dense layer with a trainable context vector u and normalized using Softmax (eq 4). The attentional vector is computed then using a weighted sum of hidden states with alignment coefficient as weights (eq 5).</p>

<p>\begin{equation}u_t = tanh(W h_t) \end{equation}
\begin{equation}\alpha_t = \frac{exp(u_{t}^{T}u)}{\sum_{t’=1}^{T}exp(u_{t’}^{T}u)} \end{equation}
\begin{equation}s = \sum_{t=1}^{T}\alpha_{t}h_{t}\end{equation}</p>

<p>The self attention can be implemented as follows using Pytorch</p>
<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">torch</span>
<span class="kn">from</span> <span class="n">torch</span> <span class="kn">import</span> <span class="n">nn</span>
<span class="kn">from</span> <span class="n">torch.utils.data</span> <span class="kn">import</span> <span class="n">DataLoader</span>


<span class="k">class</span> <span class="nc">AttentionWithContext</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="sh">"""</span><span class="s">
    Class implementing self attention mechanism:
    u_t = tanh(W . x_t)
    a_t = (u_t^T . u)/sum(u_i^T . u)
    s = sum(a_t * x_t)
    </span><span class="sh">"""</span>
  
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">input_shape</span><span class="p">,</span> <span class="n">return_coefficients</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">True</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">(</span><span class="n">AttentionWithContext</span><span class="p">,</span> <span class="n">self</span><span class="p">).</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">return_coefficients</span> <span class="o">=</span> <span class="n">return_coefficients</span>

        <span class="c1"># Dense Layer W
</span>        <span class="n">self</span><span class="p">.</span><span class="n">W</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">input_shape</span><span class="p">,</span> <span class="n">input_shape</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="n">bias</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">tanh</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Tanh</span><span class="p">()</span>
        <span class="c1"># Trainable context vector u 
</span>        <span class="n">self</span><span class="p">.</span><span class="n">u</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">input_shape</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>

        <span class="n">self</span><span class="p">.</span><span class="nf">init_weights</span><span class="p">()</span>

    <span class="k">def</span> <span class="nf">init_weights</span><span class="p">(</span><span class="n">self</span><span class="p">):</span>
        <span class="n">initrange</span> <span class="o">=</span> <span class="mf">0.1</span>
        <span class="n">self</span><span class="p">.</span><span class="n">W</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">data</span><span class="p">.</span><span class="nf">uniform_</span><span class="p">(</span><span class="o">-</span><span class="n">initrange</span><span class="p">,</span> <span class="n">initrange</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">W</span><span class="p">.</span><span class="n">bias</span><span class="p">.</span><span class="n">data</span><span class="p">.</span><span class="nf">uniform_</span><span class="p">(</span><span class="o">-</span><span class="n">initrange</span><span class="p">,</span> <span class="n">initrange</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">u</span><span class="p">.</span><span class="n">weight</span><span class="p">.</span><span class="n">data</span><span class="p">.</span><span class="nf">uniform_</span><span class="p">(</span><span class="o">-</span><span class="n">initrange</span><span class="p">,</span> <span class="n">initrange</span><span class="p">)</span>

   
    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">h</span><span class="p">):</span>
        <span class="c1"># compute uit = tanh(W . h)  where h are the hidden states
</span>        <span class="n">uit</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nc">W</span><span class="p">(</span><span class="n">h</span><span class="p">)</span>  
        <span class="n">uit</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">tanh</span><span class="p">(</span><span class="n">uit</span><span class="p">)</span> <span class="c1">#(N, L, d) --&gt; (N, L, d)
</span>        
        <span class="c1"># compute the attention coefficient alphas : u_t^T . u
</span>        <span class="n">ait</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">u</span><span class="p">(</span><span class="n">uit</span><span class="p">)</span> <span class="c1">#(N, L, 1) --&gt; (N, L, 1)
</span>        <span class="c1">#Normalizing with softmax
</span>        <span class="n">a</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">ait</span><span class="p">)</span>
        <span class="c1"># in some cases especially in the early stages of training the sum may be almost zero
</span>        <span class="c1"># and this results in NaN's. A workaround is to add a very small positive number ε to the sum.
</span>        <span class="n">eps</span> <span class="o">=</span> <span class="mf">1e-9</span>
        <span class="n">a</span> <span class="o">=</span> <span class="n">a</span> <span class="o">/</span> <span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="n">a</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">keepdim</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span> <span class="o">+</span> <span class="n">eps</span><span class="p">)</span> <span class="c1">#(N, L, 1) --&gt; (N, L, 1)
</span>        
        <span class="c1"># Compute the attentional vector : s = sum(a_t * x_t)
</span>        <span class="n">weighted_input</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">mul</span><span class="p">(</span><span class="n">a</span><span class="p">,</span> <span class="n">h</span><span class="p">),</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        
        <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">return_coefficients</span><span class="p">:</span>
            <span class="nf">return </span><span class="p">(</span>
                <span class="n">weighted_input</span><span class="p">,</span>
                <span class="n">a</span><span class="p">,</span>
            <span class="p">)</span>  <span class="c1">### [attentional vector, coefficients] ### use torch.sum to compute s
</span>        <span class="k">else</span><span class="p">:</span>
            <span class="k">return</span> <span class="n">weighted_input</span>  <span class="c1">### attentional vector only ###
</span></code></pre></div></div>

<p>The attention mechanism can provide similar summation weights for all the hidden states. A penalization term was proposed by [9] to encourage the diversity of summation weight vectors. The penalization term is as follows:</p>

\[P = {\lVert (AA^{T} - I)  \rVert}_{F}^{2}\]

<p>where F refer to the frobenius norm of a matrix \({\lVert A \rVert}_{F}^{2} = \sum_{i=1}^{n}\sum_{j=1}^{n} a_{ij}^{2}\)</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code>
<span class="k">def</span> <span class="nf">Frobenius</span><span class="p">(</span><span class="n">mat</span><span class="p">):</span>
    <span class="n">size</span> <span class="o">=</span> <span class="n">mat</span><span class="p">.</span><span class="nf">size</span><span class="p">()</span>
    <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">size</span><span class="p">)</span> <span class="o">==</span> <span class="mi">3</span><span class="p">:</span>  <span class="c1"># batched matrix
</span>        <span class="n">ret</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">sum</span><span class="p">((</span><span class="n">mat</span> <span class="o">**</span> <span class="mi">2</span><span class="p">),</span> <span class="mi">2</span><span class="p">),</span> <span class="mi">1</span><span class="p">).</span><span class="nf">squeeze</span><span class="p">()</span> <span class="o">+</span> <span class="mf">1e-10</span>
        <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="n">ret</span><span class="p">)</span> <span class="o">/</span> <span class="n">size</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
    <span class="k">else</span><span class="p">:</span>
        <span class="k">raise</span> <span class="nc">Exception</span><span class="p">(</span><span class="sh">'</span><span class="s">matrix for computing Frobenius norm should be with 3 dims</span><span class="sh">'</span><span class="p">)</span>

<span class="c1"># Create a batch of indentity matrices of size L where L represent tha length of the sequence.
</span><span class="n">I</span> <span class="o">=</span> <span class="nc">Variable</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">batch_size</span><span class="p">,</span> <span class="n">L</span><span class="p">,</span> <span class="n">L</span><span class="p">))</span>
<span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">batch_size</span><span class="p">):</span>
    <span class="k">for</span> <span class="n">j</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">L</span><span class="p">):</span>
        <span class="n">I</span><span class="p">.</span><span class="n">data</span><span class="p">[</span><span class="n">i</span><span class="p">][</span><span class="n">j</span><span class="p">][</span><span class="n">j</span><span class="p">]</span> <span class="o">=</span> <span class="mi">1</span>
<span class="c1">#Computing the penalization term
</span><span class="n">A_T</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="n">A</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">).</span><span class="nf">contiguous</span><span class="p">()</span>
<span class="n">P</span> <span class="o">=</span> <span class="nc">Frobenius</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">bmm</span><span class="p">(</span><span class="n">A</span><span class="p">,</span> <span class="n">A_T</span><span class="p">)</span> <span class="o">-</span> <span class="n">I</span><span class="p">[:</span><span class="n">A</span><span class="p">.</span><span class="nf">size</span><span class="p">(</span><span class="mi">0</span><span class="p">)])</span> 
</code></pre></div></div>

<h2 id="hierarchical-attention-network---han">Hierarchical Attention Network - HAN</h2>

<p>Hierarchical Attention Network is an interesting architecture which use self attention and was proposed by [5]. The architecture contains many level and each level is  RNNs followed by self attention layer. Which makes this architecture suitable for data that has a hierarchy e.g word —&gt; sentence —&gt; document. First, a sentence encoder produces an embedding for each sentence from word embeddings; then a document encoder produces the document embedding vector from the sentence embeddings previously produced. Each encoder is a Bidir GRU  followed by a self attention.</p>

<p>HAN makes sense for two reason: First it matches the natural hierarchy of a document; second; it allows the model to first determine which words are important in each sentence and then which sentence are important overall.</p>

<p>By being able to re-weight the word attentional coefficients by the sentence attentional coefficients the model captures the fact that a word may be very important in a sentence but it’s less important in another sentence.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">AttentionBiGRU</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">input_shape</span><span class="p">,</span> <span class="n">n_units</span><span class="p">,</span> <span class="n">index_to_word</span><span class="p">,</span> <span class="n">dropout</span><span class="o">=</span><span class="mi">0</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">(</span><span class="n">AttentionBiGRU</span><span class="p">,</span> <span class="n">self</span><span class="p">).</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">embedding</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span>
            <span class="nf">len</span><span class="p">(</span><span class="n">index_to_word</span><span class="p">)</span> <span class="o">+</span> <span class="mi">2</span><span class="p">,</span> <span class="c1"># vocab size
</span>            <span class="n">d</span><span class="p">,</span>  <span class="c1"># dimensionality of embedding space
</span>            <span class="n">padding_idx</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span>
        <span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">dropout</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Dropout</span><span class="p">(</span><span class="n">drop_rate</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">gru</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">GRU</span><span class="p">(</span>
            <span class="n">input_size</span><span class="o">=</span><span class="n">d</span><span class="p">,</span>
            <span class="n">hidden_size</span><span class="o">=</span><span class="n">n_units</span><span class="p">,</span>
            <span class="n">num_layers</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> 
            <span class="n">bias</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
            <span class="n">batch_first</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
            <span class="n">bidirectional</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
        <span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">attention</span> <span class="o">=</span> <span class="nc">AttentionWithContext</span><span class="p">(</span>
            <span class="mi">2</span> <span class="o">*</span> <span class="n">n_units</span><span class="p">,</span>  <span class="c1"># the input shape for the attention layer
</span>            <span class="n">return_coefficients</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
        <span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">sent_ints</span><span class="p">):</span>
        <span class="n">sent_wv</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">embedding</span><span class="p">(</span><span class="n">sent_ints</span><span class="p">)</span>
        <span class="n">sent_wv_dr</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">sent_wv</span><span class="p">)</span>
        <span class="n">sent_wa</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">gru</span><span class="p">(</span><span class="n">sent_wv_dr</span><span class="p">)</span>  <span class="c1"># GRU layer
</span>        <span class="n">sent_att_vec</span><span class="p">,</span> <span class="n">word_att_coeffs</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">attention</span><span class="p">(</span>
            <span class="n">sent_wa</span>
        <span class="p">)</span>  <span class="c1"># attentional vector for the sent
</span>        <span class="n">sent_att_vec_dr</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">sent_att_vec</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">sent_att_vec_dr</span><span class="p">,</span> <span class="n">word_att_coeffs</span>


<span class="k">class</span> <span class="nc">TimeDistributed</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">module</span><span class="p">,</span> <span class="n">batch_first</span><span class="o">=</span><span class="bp">False</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">(</span><span class="n">TimeDistributed</span><span class="p">,</span> <span class="n">self</span><span class="p">).</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">module</span> <span class="o">=</span> <span class="n">module</span>
        <span class="n">self</span><span class="p">.</span><span class="n">batch_first</span> <span class="o">=</span> <span class="n">batch_first</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="k">if</span> <span class="nf">len</span><span class="p">(</span><span class="n">x</span><span class="p">.</span><span class="nf">size</span><span class="p">())</span> <span class="o">&lt;=</span> <span class="mi">2</span><span class="p">:</span>
            <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">module</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
        <span class="c1"># Squash samples and timesteps into a single axis
</span>        <span class="n">x_reshape</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="nf">contiguous</span><span class="p">().</span><span class="nf">view</span><span class="p">(</span>
            <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">x</span><span class="p">.</span><span class="nf">size</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
        <span class="p">)</span>  <span class="c1"># (samples * timesteps, input_size) (224, 30)
</span>        <span class="n">sent_att_vec_dr</span><span class="p">,</span> <span class="n">word_att_coeffs</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">module</span><span class="p">(</span><span class="n">x_reshape</span><span class="p">)</span>
        <span class="c1"># We have to reshape the output
</span>        <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">batch_first</span><span class="p">:</span>
            <span class="n">sent_att_vec_dr</span> <span class="o">=</span> <span class="n">sent_att_vec_dr</span><span class="p">.</span><span class="nf">contiguous</span><span class="p">().</span><span class="nf">view</span><span class="p">(</span>
                <span class="n">x</span><span class="p">.</span><span class="nf">size</span><span class="p">(</span><span class="mi">0</span><span class="p">),</span> <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">sent_att_vec_dr</span><span class="p">.</span><span class="nf">size</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
            <span class="p">)</span>  <span class="c1"># (samples, timesteps, output_size)
</span>            <span class="n">word_att_coeffs</span> <span class="o">=</span> <span class="n">word_att_coeffs</span><span class="p">.</span><span class="nf">contiguous</span><span class="p">().</span><span class="nf">view</span><span class="p">(</span>
                <span class="n">x</span><span class="p">.</span><span class="nf">size</span><span class="p">(</span><span class="mi">0</span><span class="p">),</span> <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">word_att_coeffs</span><span class="p">.</span><span class="nf">size</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
            <span class="p">)</span>  <span class="c1"># (samples, timesteps, output_size)
</span>        <span class="k">else</span><span class="p">:</span>
            <span class="n">sent_att_vec_dr</span> <span class="o">=</span> <span class="n">sent_att_vec_dr</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span>
                <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">x</span><span class="p">.</span><span class="nf">size</span><span class="p">(</span><span class="mi">1</span><span class="p">),</span> <span class="n">sent_att_vec_dr</span><span class="p">.</span><span class="nf">size</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
            <span class="p">)</span>  <span class="c1"># (timesteps, samples, output_size)
</span>            <span class="n">word_att_coeffs</span> <span class="o">=</span> <span class="n">word_att_coeffs</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span>
                <span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="n">x</span><span class="p">.</span><span class="nf">size</span><span class="p">(</span><span class="mi">1</span><span class="p">),</span> <span class="n">word_att_coeffs</span><span class="p">.</span><span class="nf">size</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
            <span class="p">)</span>  <span class="c1"># (timesteps, samples, output_size)
</span>        <span class="k">return</span> <span class="n">sent_att_vec_dr</span><span class="p">,</span> <span class="n">word_att_coeffs</span>


<span class="k">class</span> <span class="nc">HAN</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">input_shape</span><span class="p">,</span> <span class="n">n_units</span><span class="p">,</span> <span class="n">index_to_word</span><span class="p">,</span> <span class="n">dropout</span><span class="o">=</span><span class="mi">0</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">(</span><span class="n">HAN</span><span class="p">,</span> <span class="n">self</span><span class="p">).</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">encoder</span> <span class="o">=</span> <span class="nc">AttentionBiGRU</span><span class="p">(</span><span class="n">input_shape</span><span class="p">,</span> <span class="n">n_units</span><span class="p">,</span> <span class="n">index_to_word</span><span class="p">,</span> <span class="n">dropout</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">timeDistributed</span> <span class="o">=</span> <span class="nc">TimeDistributed</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">encoder</span><span class="p">,</span> <span class="bp">True</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">dropout</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Dropout</span><span class="p">(</span><span class="n">drop_rate</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">gru</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">GRU</span><span class="p">(</span>
            <span class="n">input_size</span><span class="o">=</span><span class="mi">2</span> <span class="o">*</span> <span class="n">n_units</span><span class="p">,</span>  <span class="c1"># the input shape of GRU layer
</span>            <span class="n">hidden_size</span><span class="o">=</span><span class="n">n_units</span><span class="p">,</span>
            <span class="n">num_layers</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span>
            <span class="n">bias</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
            <span class="n">batch_first</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
            <span class="n">bidirectional</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
        <span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">attention</span> <span class="o">=</span> <span class="nc">AttentionWithContext</span><span class="p">(</span>
            <span class="mi">2</span>
            <span class="o">*</span> <span class="n">n_units</span><span class="p">,</span>  <span class="c1"># the input shape of between-sentence attention layer
</span>            <span class="n">return_coefficients</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
        <span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">lin_out</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span>
            <span class="mi">2</span> <span class="o">*</span> <span class="n">n_units</span><span class="p">,</span> <span class="mi">1</span>  <span class="c1"># the input size of the last linear layer
</span>        <span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">preds</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Sigmoid</span><span class="p">()</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">doc_ints</span><span class="p">):</span>
        <span class="n">sent_att_vecs_dr</span><span class="p">,</span> <span class="n">word_att_coeffs</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">timeDistributed</span><span class="p">(</span>
            <span class="n">doc_ints</span>
        <span class="p">)</span>  <span class="c1"># get sentence representation
</span>        <span class="n">doc_sa</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">gru</span><span class="p">(</span><span class="n">sent_att_vecs_dr</span><span class="p">)</span>
        <span class="n">doc_att_vec</span><span class="p">,</span> <span class="n">sent_att_coeffs</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">attention</span><span class="p">(</span><span class="n">doc_sa</span><span class="p">)</span>
        <span class="n">doc_att_vec_dr</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">dropout</span><span class="p">(</span><span class="n">doc_att_vec</span><span class="p">)</span>
        <span class="n">doc_att_vec_dr</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">lin_out</span><span class="p">(</span><span class="n">doc_att_vec_dr</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">preds</span><span class="p">(</span><span class="n">doc_att_vec_dr</span><span class="p">),</span> <span class="n">word_att_coeffs</span><span class="p">,</span> <span class="n">sent_att_coeffs</span>

</code></pre></div></div>

<p>While HAN is an interesting architecture, it has a major limitation. For a given sentence, the embedding is produced in isolation. This means, it ignores the other sentences. So, If redundant parts exist in the document; the model can spend the attention budget on them and neglects the others aspects.</p>

<h3 id="dataset">Dataset</h3>
<p>The dataset considered in this application is IMDB review dataset. It contains reviews about movies and their classes, positive or negative. The goal is to classify these reviews into positive or negative.</p>

<p>Each review is converted to an array of integers that has a size of \((1, doc_size, sent_size)\). the <em>doc{_}size</em> specifies the maximum number of allowed sentences per document and <em>sent{_}size</em> the specifies the maximum number of allowed words per sentence. Smaller sentences are padded by a special padding token and smaller documents are padded with sentences containing only a special padding token. Longer documents or sentences are truncated.</p>

<p>The mapping of a word to an integers is done by creating a vocabulary dictionary from the training set where each word has an integer value. The most frequent word has a value of 2. 0 and 1 are reserved for special token and out of vocabulary token.</p>

<p>An example of a sentence and its mapping to an array of integers:</p>

<div class="language-markdown highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Sentence:

"There 's a sign on The Lost Highway that says : OOV SPOILERS OOV ( but you already knew that , did n't you ? )"
</code></pre></div></div>

<div class="language-markdown highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Corresponding array:

array([  130,    14,     6,  1991,    28,    22,  2746, 17943,    13,
         564,    85,     1,  3225,     1,    25,    26,    29,   488,
         697,    13,     3,    84,    27,    29,    45,    24,     0,
           0,     0,     0])
</code></pre></div></div>

<p>We have some 0 in the end of the array as the choosen <em>sent_size</em> is 30 and the sentence needs to be padded because it contains only 26 words.</p>

<h2 id="training">Training</h2>
<p>The training consists of minimizing a loss function. As we are dealing with classification problem, the loss used is <em>Binary Cross Entropy (BCE)</em>:</p>

\[L(\hat{y}, y) =\frac{1}{N} \sum_{i=1}^N y_i log(\hat{y}_i) + (1-y_i)log(1-\hat{y}_i)\]

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">model</span> <span class="o">=</span> <span class="nc">HAN</span><span class="p">(</span><span class="n">input_size</span><span class="p">,</span> <span class="n">n_units</span><span class="p">,</span> <span class="n">index_to_word</span><span class="p">).</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
<span class="n">model</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">double</span><span class="p">()</span>
<span class="n">lr</span> <span class="o">=</span> <span class="mf">0.001</span>  <span class="c1"># learning rate
</span><span class="n">criterion</span> <span class="o">=</span> <span class="p">(</span>
    <span class="n">nn</span><span class="p">.</span><span class="nc">BCELoss</span><span class="p">()</span>
<span class="p">)</span>  <span class="c1"># Binary cross entropy from torch.nn: https://pytorch.org/docs/stable/nn.html#loss-functions
</span><span class="n">optimizer</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">optim</span><span class="p">.</span><span class="nc">Adam</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="n">lr</span><span class="o">=</span><span class="n">lr</span><span class="p">)</span>  <span class="c1"># Adam optimizer
</span>
<span class="k">def</span> <span class="nf">train</span><span class="p">(</span>
    <span class="n">x_train</span><span class="o">=</span><span class="n">my_docs_array_train</span><span class="p">,</span>
    <span class="n">y_train</span><span class="o">=</span><span class="n">my_labels_array_train</span><span class="p">,</span>
    <span class="n">x_test</span><span class="o">=</span><span class="n">my_docs_array_test</span><span class="p">,</span>
    <span class="n">y_test</span><span class="o">=</span><span class="n">my_labels_array_test</span><span class="p">,</span>
    <span class="n">word_dict</span><span class="o">=</span><span class="n">index_to_word</span><span class="p">,</span>
    <span class="n">batch_size</span><span class="o">=</span><span class="n">batch_size</span><span class="p">,</span>
<span class="p">):</span>

    <span class="n">train_data</span> <span class="o">=</span> <span class="nf">get_loader</span><span class="p">(</span><span class="n">x_train</span><span class="p">,</span> <span class="n">y_train</span><span class="p">,</span> <span class="n">batch_size</span><span class="p">)</span>
    <span class="n">test_data</span> <span class="o">=</span> <span class="nf">get_loader</span><span class="p">(</span><span class="n">my_docs_array_test</span><span class="p">,</span> <span class="n">my_labels_array_test</span><span class="p">,</span> <span class="n">batch_size</span><span class="p">)</span>

    <span class="n">best_validation_acc</span> <span class="o">=</span> <span class="mf">0.0</span>
    <span class="n">p</span> <span class="o">=</span> <span class="mi">0</span>  <span class="c1"># patience
</span>
    <span class="k">for</span> <span class="n">epoch</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="n">nb_epochs</span> <span class="o">+</span> <span class="mi">1</span><span class="p">):</span>
        <span class="n">losses</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="n">accuracies</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="k">with</span> <span class="nf">tqdm</span><span class="p">(</span><span class="n">train_data</span><span class="p">,</span> <span class="n">unit</span><span class="o">=</span><span class="sh">"</span><span class="s">batch</span><span class="sh">"</span><span class="p">)</span> <span class="k">as</span> <span class="n">tepoch</span><span class="p">:</span>
            <span class="k">for</span> <span class="n">idx</span><span class="p">,</span> <span class="n">data</span> <span class="ow">in</span> <span class="nf">enumerate</span><span class="p">(</span><span class="n">tepoch</span><span class="p">):</span>
                <span class="n">tepoch</span><span class="p">.</span><span class="nf">set_description</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">Epoch </span><span class="si">{</span><span class="n">epoch</span><span class="si">}</span><span class="sh">"</span><span class="p">)</span>
                <span class="n">model</span><span class="p">.</span><span class="nf">train</span><span class="p">()</span>
                <span class="n">optimizer</span><span class="p">.</span><span class="nf">zero_grad</span><span class="p">()</span>
                <span class="nb">input</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="sh">"</span><span class="s">document</span><span class="sh">"</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
                <span class="n">label</span> <span class="o">=</span> <span class="n">data</span><span class="p">[</span><span class="sh">"</span><span class="s">label</span><span class="sh">"</span><span class="p">].</span><span class="nf">to</span><span class="p">(</span><span class="n">device</span><span class="p">)</span>
                <span class="n">label</span> <span class="o">=</span> <span class="n">label</span><span class="p">.</span><span class="nf">double</span><span class="p">()</span>
                <span class="n">out</span> <span class="o">=</span> <span class="n">model</span><span class="p">.</span><span class="nf">forward</span><span class="p">(</span><span class="nb">input</span><span class="p">)</span>
                <span class="n">output</span> <span class="o">=</span> <span class="n">out</span><span class="p">[</span><span class="mi">0</span><span class="p">][:,</span> <span class="o">-</span><span class="mi">1</span><span class="p">]</span>
                <span class="n">loss</span> <span class="o">=</span> <span class="nf">criterion</span><span class="p">(</span><span class="n">output</span><span class="p">,</span> <span class="n">label</span><span class="p">)</span>    <span class="c1"># compute the loss
</span>                <span class="n">loss</span><span class="p">.</span><span class="nf">backward</span><span class="p">()</span>
                <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="n">utils</span><span class="p">.</span><span class="nf">clip_grad_norm_</span><span class="p">(</span>
                    <span class="n">model</span><span class="p">.</span><span class="nf">parameters</span><span class="p">(),</span> <span class="mf">0.5</span>
                <span class="p">)</span>  <span class="c1"># Clipping to prevent exploding gradient
</span>                <span class="n">optimizer</span><span class="p">.</span><span class="nf">step</span><span class="p">()</span>

                <span class="n">losses</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">loss</span><span class="p">.</span><span class="nf">item</span><span class="p">())</span>
                <span class="n">accuracy</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">round</span><span class="p">(</span><span class="n">output</span><span class="p">)</span> <span class="o">==</span> <span class="n">label</span><span class="p">).</span><span class="nf">item</span><span class="p">()</span> <span class="o">/</span> <span class="n">batch_size</span>
                <span class="n">accuracies</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">accuracy</span><span class="p">)</span>
                <span class="n">tepoch</span><span class="p">.</span><span class="nf">set_postfix</span><span class="p">(</span>
                    <span class="n">loss</span><span class="o">=</span><span class="nf">sum</span><span class="p">(</span><span class="n">losses</span><span class="p">)</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">losses</span><span class="p">),</span>
                    <span class="n">accuracy</span><span class="o">=</span><span class="mf">100.0</span> <span class="o">*</span> <span class="nf">sum</span><span class="p">(</span><span class="n">accuracies</span><span class="p">)</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">accuracies</span><span class="p">),</span>
                <span class="p">)</span>

        <span class="n">train_acc</span> <span class="o">=</span> <span class="nf">evaluate_accuracy</span><span class="p">(</span><span class="n">train_data</span><span class="p">,</span> <span class="bp">False</span><span class="p">)</span>
        <span class="n">test_acc</span> <span class="o">=</span> <span class="nf">evaluate_accuracy</span><span class="p">(</span><span class="n">test_data</span><span class="p">,</span> <span class="bp">False</span><span class="p">)</span>
        <span class="nf">print</span><span class="p">(</span>
            <span class="sh">"</span><span class="s">===&gt; Epoch {} Complete: Avg. Loss: {:.4f}, Validation Accuracy: {:3.2f}%</span><span class="sh">"</span><span class="p">.</span><span class="nf">format</span><span class="p">(</span>
                <span class="n">epoch</span><span class="p">,</span> <span class="nf">sum</span><span class="p">(</span><span class="n">losses</span><span class="p">)</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">losses</span><span class="p">),</span> <span class="mf">100.0</span> <span class="o">*</span> <span class="n">test_acc</span>
            <span class="p">)</span>
        <span class="p">)</span>
        <span class="k">if</span> <span class="n">test_acc</span> <span class="o">&gt;=</span> <span class="n">best_validation_acc</span><span class="p">:</span>
            <span class="n">best_validation_acc</span> <span class="o">=</span> <span class="n">test_acc</span>
            <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">Validation accuracy improved, saving model...</span><span class="sh">"</span><span class="p">)</span>
            <span class="n">torch</span><span class="p">.</span><span class="nf">save</span><span class="p">(</span><span class="n">model</span><span class="p">.</span><span class="nf">state_dict</span><span class="p">(),</span> <span class="sh">"</span><span class="s">./best_model.pt</span><span class="sh">"</span><span class="p">)</span>
            <span class="n">p</span> <span class="o">=</span> <span class="mi">0</span>
            <span class="nf">print</span><span class="p">()</span>
        <span class="k">else</span><span class="p">:</span>
            <span class="n">p</span> <span class="o">+=</span> <span class="mi">1</span>
            <span class="k">if</span> <span class="n">p</span> <span class="o">==</span> <span class="n">my_patience</span><span class="p">:</span>
                <span class="nf">print</span><span class="p">(</span>
                    <span class="sh">"</span><span class="s">Validation accuracy did not improve for {} epochs, stopping training...</span><span class="sh">"</span><span class="p">.</span><span class="nf">format</span><span class="p">(</span>
                        <span class="n">my_patience</span>
                    <span class="p">)</span>
                <span class="p">)</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">Loading best checkpoint...</span><span class="sh">"</span><span class="p">)</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">load_state_dict</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">load</span><span class="p">(</span><span class="sh">"</span><span class="s">./best_model.pt</span><span class="sh">"</span><span class="p">))</span>
    <span class="n">model</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>
    <span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">done.</span><span class="sh">"</span><span class="p">)</span>


<span class="nf">train</span><span class="p">()</span>
</code></pre></div></div>

<h2 id="analysis">Analysis</h2>

<p>Using the mean of the hidden state of GRU instead attention will lead to treating the hidden state in a sequence equally. This lead to the same contribution of irrelevant elements to the prediction with the same importance as relevant element. Which can be subject to poor performances.
So, the advantage of the attention mechanism is to have weights releaving the importance of each hidden state; and so each element, in the sequence (words in case of sentence, and sentences in case of a document).</p>

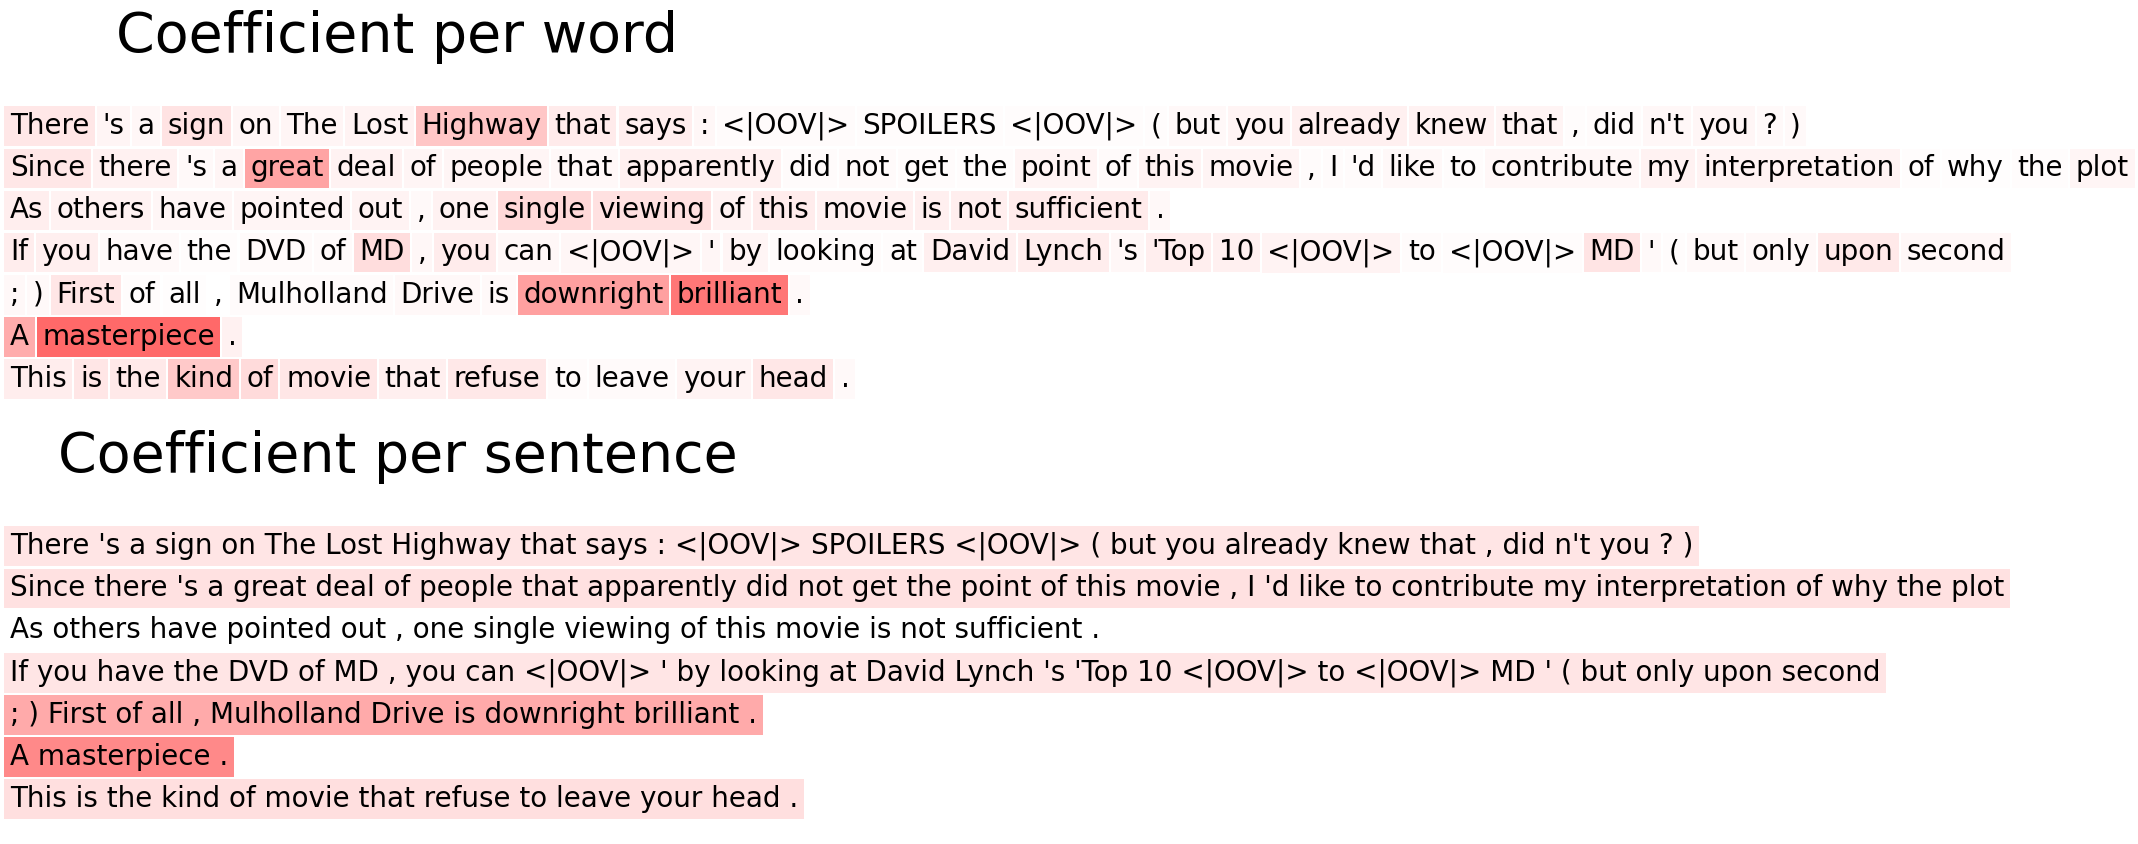
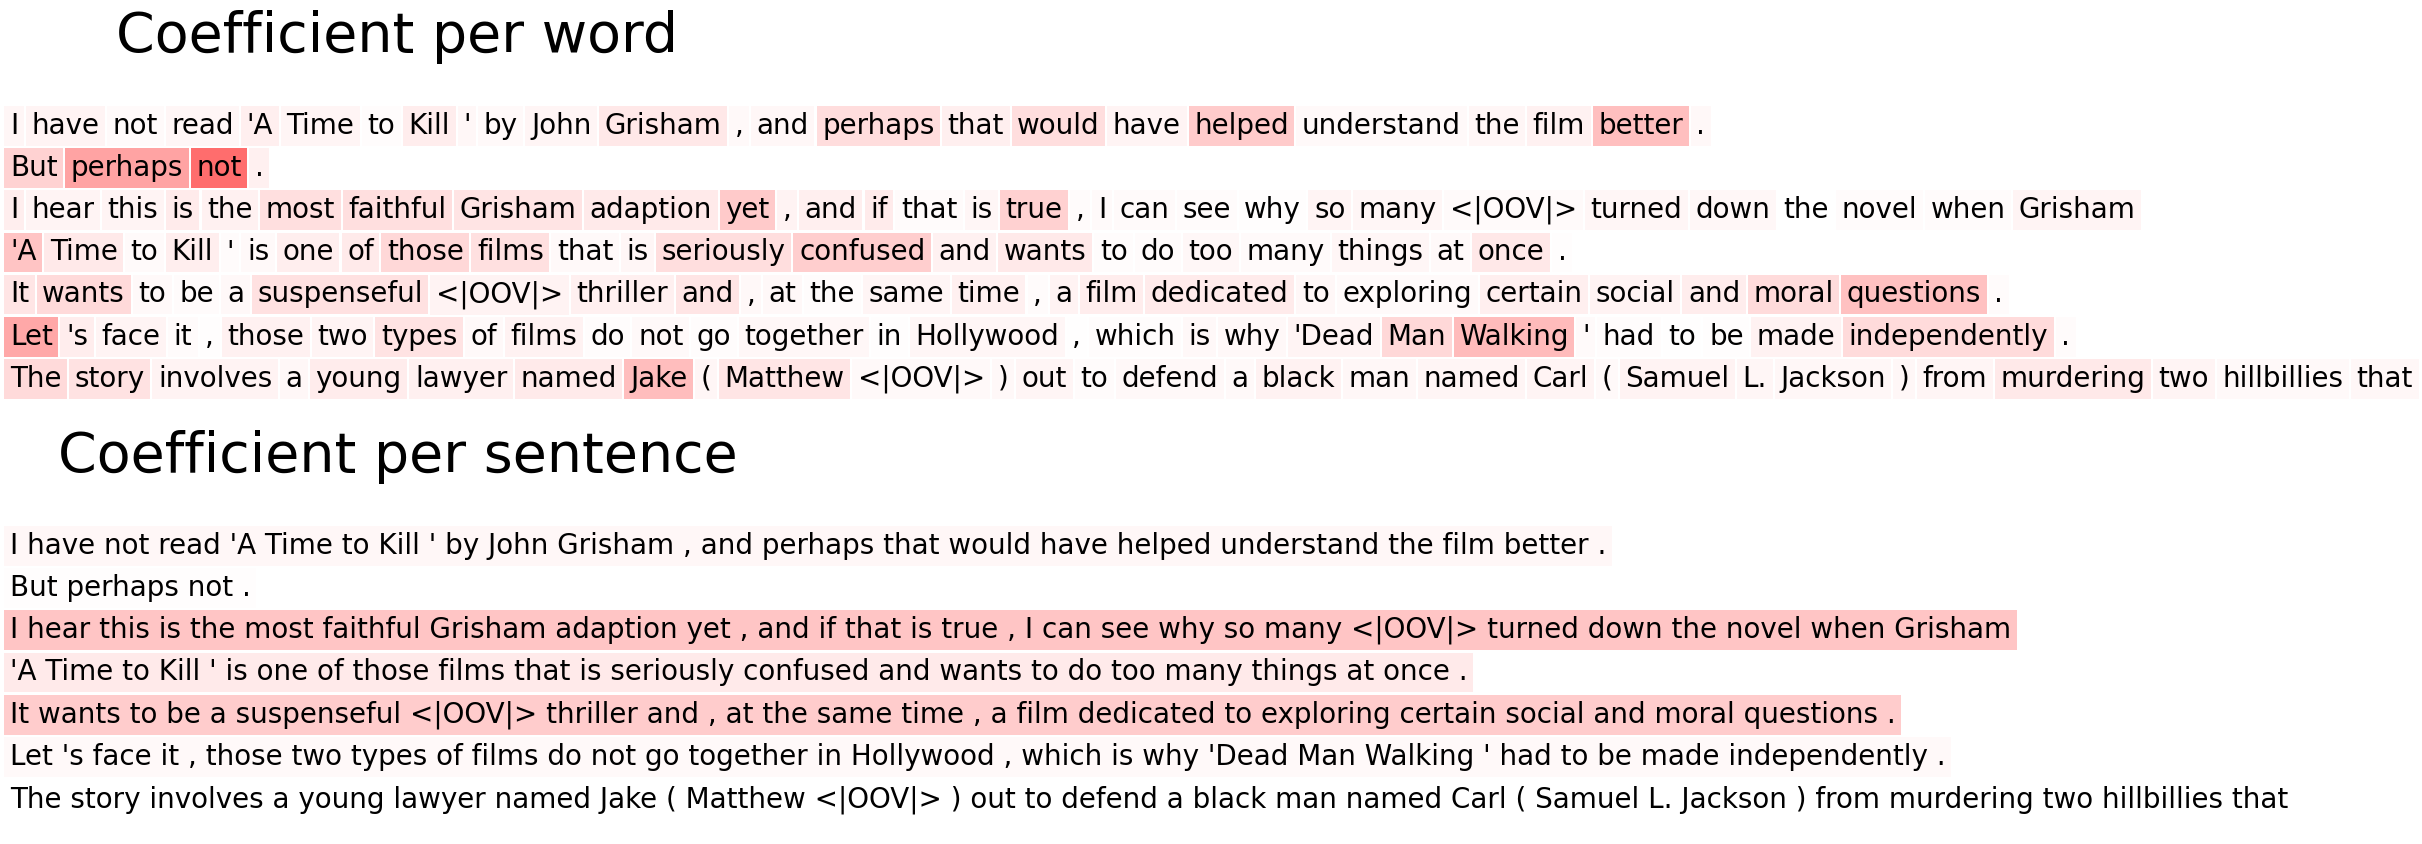
<p>The following plots, shows the attention coefficient per words and per sentences of positive and negative  reviews from the test set. The more the sentence or the word is red, the more the attention of this element is high. <em>&lt;|OOV|&gt;</em> means Out Of Vocabulary, is a token to replace words that are not in the training vocabulary.</p>

<figure class="figure figure-wide">
<img src="/assets/blog/han_blog/last_review_coeff.png" alt="Attention weights on a **positive** test review. Top: word-level coefficients; bottom: sentence-level coefficients. Darker red means higher attention." loading="lazy" decoding="async" data-zoomable="" />
<figcaption>Attention weights on a <strong>positive</strong> test review. Top: word-level coefficients; bottom: sentence-level coefficients. Darker red means higher attention.</figcaption>
</figure>

<figure class="figure figure-wide">
<img src="/assets/blog/han_blog/neg_review_coeff.png" alt="Attention weights on a **negative** test review, shown the same way." loading="lazy" decoding="async" data-zoomable="" />
<figcaption>Attention weights on a <strong>negative</strong> test review, shown the same way.</figcaption>
</figure>

<p>From the plots, we can see that words and sentence that relevant and more linked to a positive or negative reviews have a high attention coefficient regarding the other words. 
For example in the positive review, we have words such as “Brilliant”, “Master Piece”, “Great” which are positive and have a high attention. Same remark for sentences such as “:) First of all, Mulholland Drive is downright brilliant.” or “A masterpiece”. 
In the negative review we have words or sentences with a negative tonality have a high attention; such as “confused” “suspenful”.</p>]]></content><author><name>Rida Lefdali</name></author><category term="Technical-post," /><category term="ML" /><summary type="html"><![CDATA[In this posts, we will try to get familiar with RNN, self-attention and HAN architectures. Data exists in many types such as tabular, imgaes, graph, texts etc. Sequential data is data arranged in an ordered sequence. It could be ordered by time, e.g time series, or by position, e.g text. generally, we model the sequence as follows: \((x_{1}, x_{2}, …, x_{T})\), where \((x_{i})\) could be a word in case of a text, a real value in case of a time series etc… .]]></summary></entry><entry><title type="html">Hello World</title><link href="https://lefdrida.github.io/posts/2025/hello_world/" rel="alternate" type="text/html" title="Hello World" /><published>2025-03-20T15:12:00+00:00</published><updated>2025-03-20T15:12:00+00:00</updated><id>https://lefdrida.github.io/posts/2025/hello_world</id><content type="html" xml:base="https://lefdrida.github.io/posts/2025/hello_world/"><![CDATA[<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1">#!/usr/bin/env python
</span><span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">Hello World</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div>]]></content><author><name>Rida Lefdali</name></author><category term="Technical-post," /><category term="ML" /><summary type="html"><![CDATA[#!/usr/bin/env python print("Hello World")]]></summary></entry><entry><title type="html">Depth Estimation</title><link href="https://lefdrida.github.io/posts/2025/depth_estimation/" rel="alternate" type="text/html" title="Depth Estimation" /><published>2025-03-18T15:12:00+00:00</published><updated>2025-03-18T15:12:00+00:00</updated><id>https://lefdrida.github.io/posts/2025/depth_estimation</id><content type="html" xml:base="https://lefdrida.github.io/posts/2025/depth_estimation/"><![CDATA[<h2 id="monocular-3d-mapping">Monocular 3D Mapping</h2>

<p>Depth estimation is a task consisting of estimating the distance of each pixel realtive to the camera to result in a depth map. Using the depth map with some camera parameters, explained later, we can map an image $ I \in\mathbb{R}^{M\times N \times 3}$ to its 3D point cloud $X \in\mathbb{R}^{M \times N \times 3}$. This means, we can map each pixel in the 2D image to its corresponding point in the 3D space.</p>

<p>A camera projects a 3D point in the real worl to a 2D point on the image. This transformation can be modeled using matrix multiplication using the intersic camera parameters and extrinsic camera parameters. 
The camera extrinsic matrix (parameters), denoted $E$, is used to map a 3D point in the real world reference to a 3D point cloud in the camera reference.
The camera intrinsic matrix (parameters), denoted $K$ is, used to map a 3D camera centered point to a 2D point on the image plane.</p>

<p>The matrix $K$ and $E$ are defined as follows:</p>

\[\left\lbrace
\begin{aligned}
&amp; K = 
\begin{pmatrix}
&amp;f_x  &amp;0   &amp; c_x  \\
&amp;0   &amp;f_y   &amp; c_y  \\
&amp;0   &amp;0   &amp; 1  \\
\end{pmatrix}
\substack{\text{such that $(f_{x}, f_{y})$ are the focal lengths of the camera} \\ \text{and $(c_{x}, c_{y})$ is the camera optical center.}} \\
\text{and}\\
&amp; E = [R|T] =
\begin{pmatrix}
&amp;r_{11}   &amp;r_{12}   &amp; r_{13} &amp; t_{1} \\
&amp;r_{21}   &amp;r_{22}   &amp; r_{23} &amp; t_{2} \\
&amp;r_{31}   &amp;r_{32}   &amp; r_{33} &amp; t_{3} \\
\end{pmatrix} 
\substack{\text{which contains the rotation matrix} \\ \text{and translation vector}} \\
\end{aligned}
\right.\]

<p>So, given the intrinsic matrix $K$ and the depth map $D$, and using the pinhole camera model, we can map each pixel $p_{i}=(x_{i}, y_{i})^{T}$ in the 2D image plane to its corresponding the 3D point in the camera referential $P_{c, i} = (X_{c, i}, Y_{c, i}, Z_{c, i})^{T}$
using the schema below:</p>

\[\left\lbrace
\begin{aligned}
&amp; X_{c, i} = \frac{(x_{i} - c_x)Z_{c, i}}{f_x}\\
&amp; Y_{c, i} = \frac{(y_{i} - c_y)Z_{c, i}}{f_y}\\
&amp; Z_{c, i} = D(x_{i}, y_{i}) \quad \text{(the depth value corresponding to the pixel $p_{i}$)}
\end{aligned}
\right.\]

<p>We will be interested in only on mapping the image pixel to its 3D point in the camera referential.\</p>

<p>To map to the 3D real world space, we can use the relationshape between a point in the camera referential $P_{c}$ and its corresponding point in the real world referential $P_{r}$, which is:</p>

\[\left\lbrace
\begin{aligned}
&amp; P_{c} = RP_{r} + T  \quad \text{where $P_{r} = (X_{r}, Y_{r}, Z_{r})^{T}$,  $T$ and $R$ are the translation vector and rotation matrices}\\
&amp; RP_{r} = P_{c} - T \\
&amp; P_{r} = R^{T}(P_{c} - T) \quad \text{The rotation matrix is always invertible. And as it is orthogonal ans its inverse is its transpose.} \\
\end{aligned}
\right.\]

<p>The following python function implements the pinhole model to generate 3D point in the camera referential using depth map and the intrinsic matrix.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">generate_point_cloud</span><span class="p">(</span><span class="n">depth_map</span><span class="p">,</span> <span class="n">intrinsic_matrix</span><span class="p">,</span> <span class="n">depth_info</span><span class="p">,</span> <span class="n">rgb_image</span><span class="o">=</span><span class="bp">None</span><span class="p">):</span>
    <span class="c1"># Image dimensions
</span>    <span class="n">H</span><span class="p">,</span> <span class="n">W</span> <span class="o">=</span> <span class="n">depth_map</span><span class="p">.</span><span class="n">shape</span>
    <span class="c1"># Intrinsic parameters
</span>    <span class="n">fx</span><span class="p">,</span> <span class="n">fy</span> <span class="o">=</span> <span class="n">intrinsic_matrix</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">0</span><span class="p">],</span> <span class="n">intrinsic_matrix</span><span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">]</span>
    <span class="n">cx</span><span class="p">,</span> <span class="n">cy</span> <span class="o">=</span> <span class="n">intrinsic_matrix</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">2</span><span class="p">],</span> <span class="n">intrinsic_matrix</span><span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">]</span>
    <span class="n">depth_max</span> <span class="o">=</span> <span class="n">depth_info</span><span class="p">[</span><span class="mi">3</span><span class="p">]</span> <span class="c1"># If depth info are provided
</span>    <span class="n">depth_min</span> <span class="o">=</span> <span class="n">depth_info</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
    
    <span class="c1"># Create a grid of pixel coordinates
</span>    <span class="n">u</span><span class="p">,</span> <span class="n">v</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">meshgrid</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">W</span><span class="p">),</span> <span class="n">np</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">H</span><span class="p">))</span>
    <span class="c1"># Convert to normalized camera coordinates
</span>    <span class="n">x_norm</span> <span class="o">=</span> <span class="p">(</span><span class="n">u</span> <span class="o">-</span> <span class="n">cx</span><span class="p">)</span> <span class="o">/</span> <span class="n">fx</span>
    <span class="n">y_norm</span> <span class="o">=</span> <span class="p">(</span><span class="n">v</span> <span class="o">-</span> <span class="n">cy</span><span class="p">)</span> <span class="o">/</span> <span class="n">fy</span>
    <span class="c1"># Back-project to 3D camera coordinates
</span>    <span class="n">z_cam</span> <span class="o">=</span> <span class="n">depth_map</span>
    <span class="n">x_cam</span> <span class="o">=</span> <span class="n">z_cam</span> <span class="o">*</span> <span class="n">x_norm</span>
    <span class="n">y_cam</span> <span class="o">=</span> <span class="n">z_cam</span> <span class="o">*</span> <span class="n">y_norm</span>
    <span class="c1"># Stack into a 3D array (camera coordinates)
</span>    <span class="n">points_cam</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">stack</span><span class="p">((</span><span class="n">x_cam</span><span class="p">,</span> <span class="n">z_cam</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="o">*</span><span class="n">y_cam</span><span class="p">),</span> <span class="n">axis</span><span class="o">=-</span><span class="mi">1</span><span class="p">).</span><span class="nf">reshape</span><span class="p">(</span><span class="o">-</span><span class="mi">1</span><span class="p">,</span> <span class="mi">3</span><span class="p">)</span>
    <span class="k">if</span> <span class="n">rgb_image</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
      <span class="n">colors</span> <span class="o">=</span> <span class="n">rgb_image</span><span class="p">[</span><span class="n">v</span><span class="p">,</span> <span class="n">u</span><span class="p">]</span> <span class="o">/</span> <span class="mf">255.0</span>
    <span class="k">return</span> <span class="n">points_cam</span><span class="p">,</span> <span class="n">colors</span>
</code></pre></div></div>

<h2 id="nuy-depth-v2-dataset">NUY Depth V2 dataset</h2>

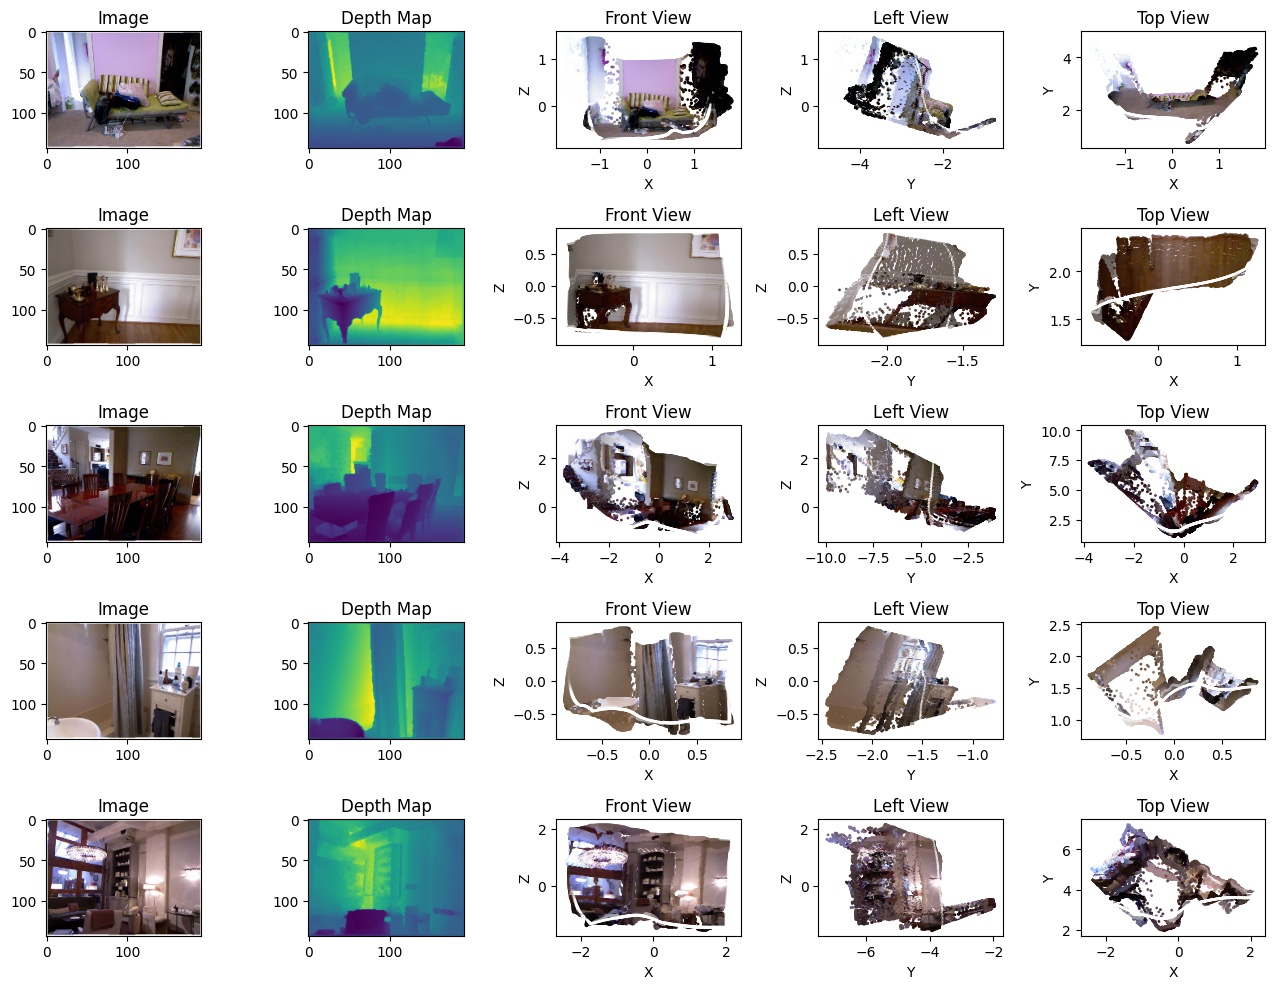
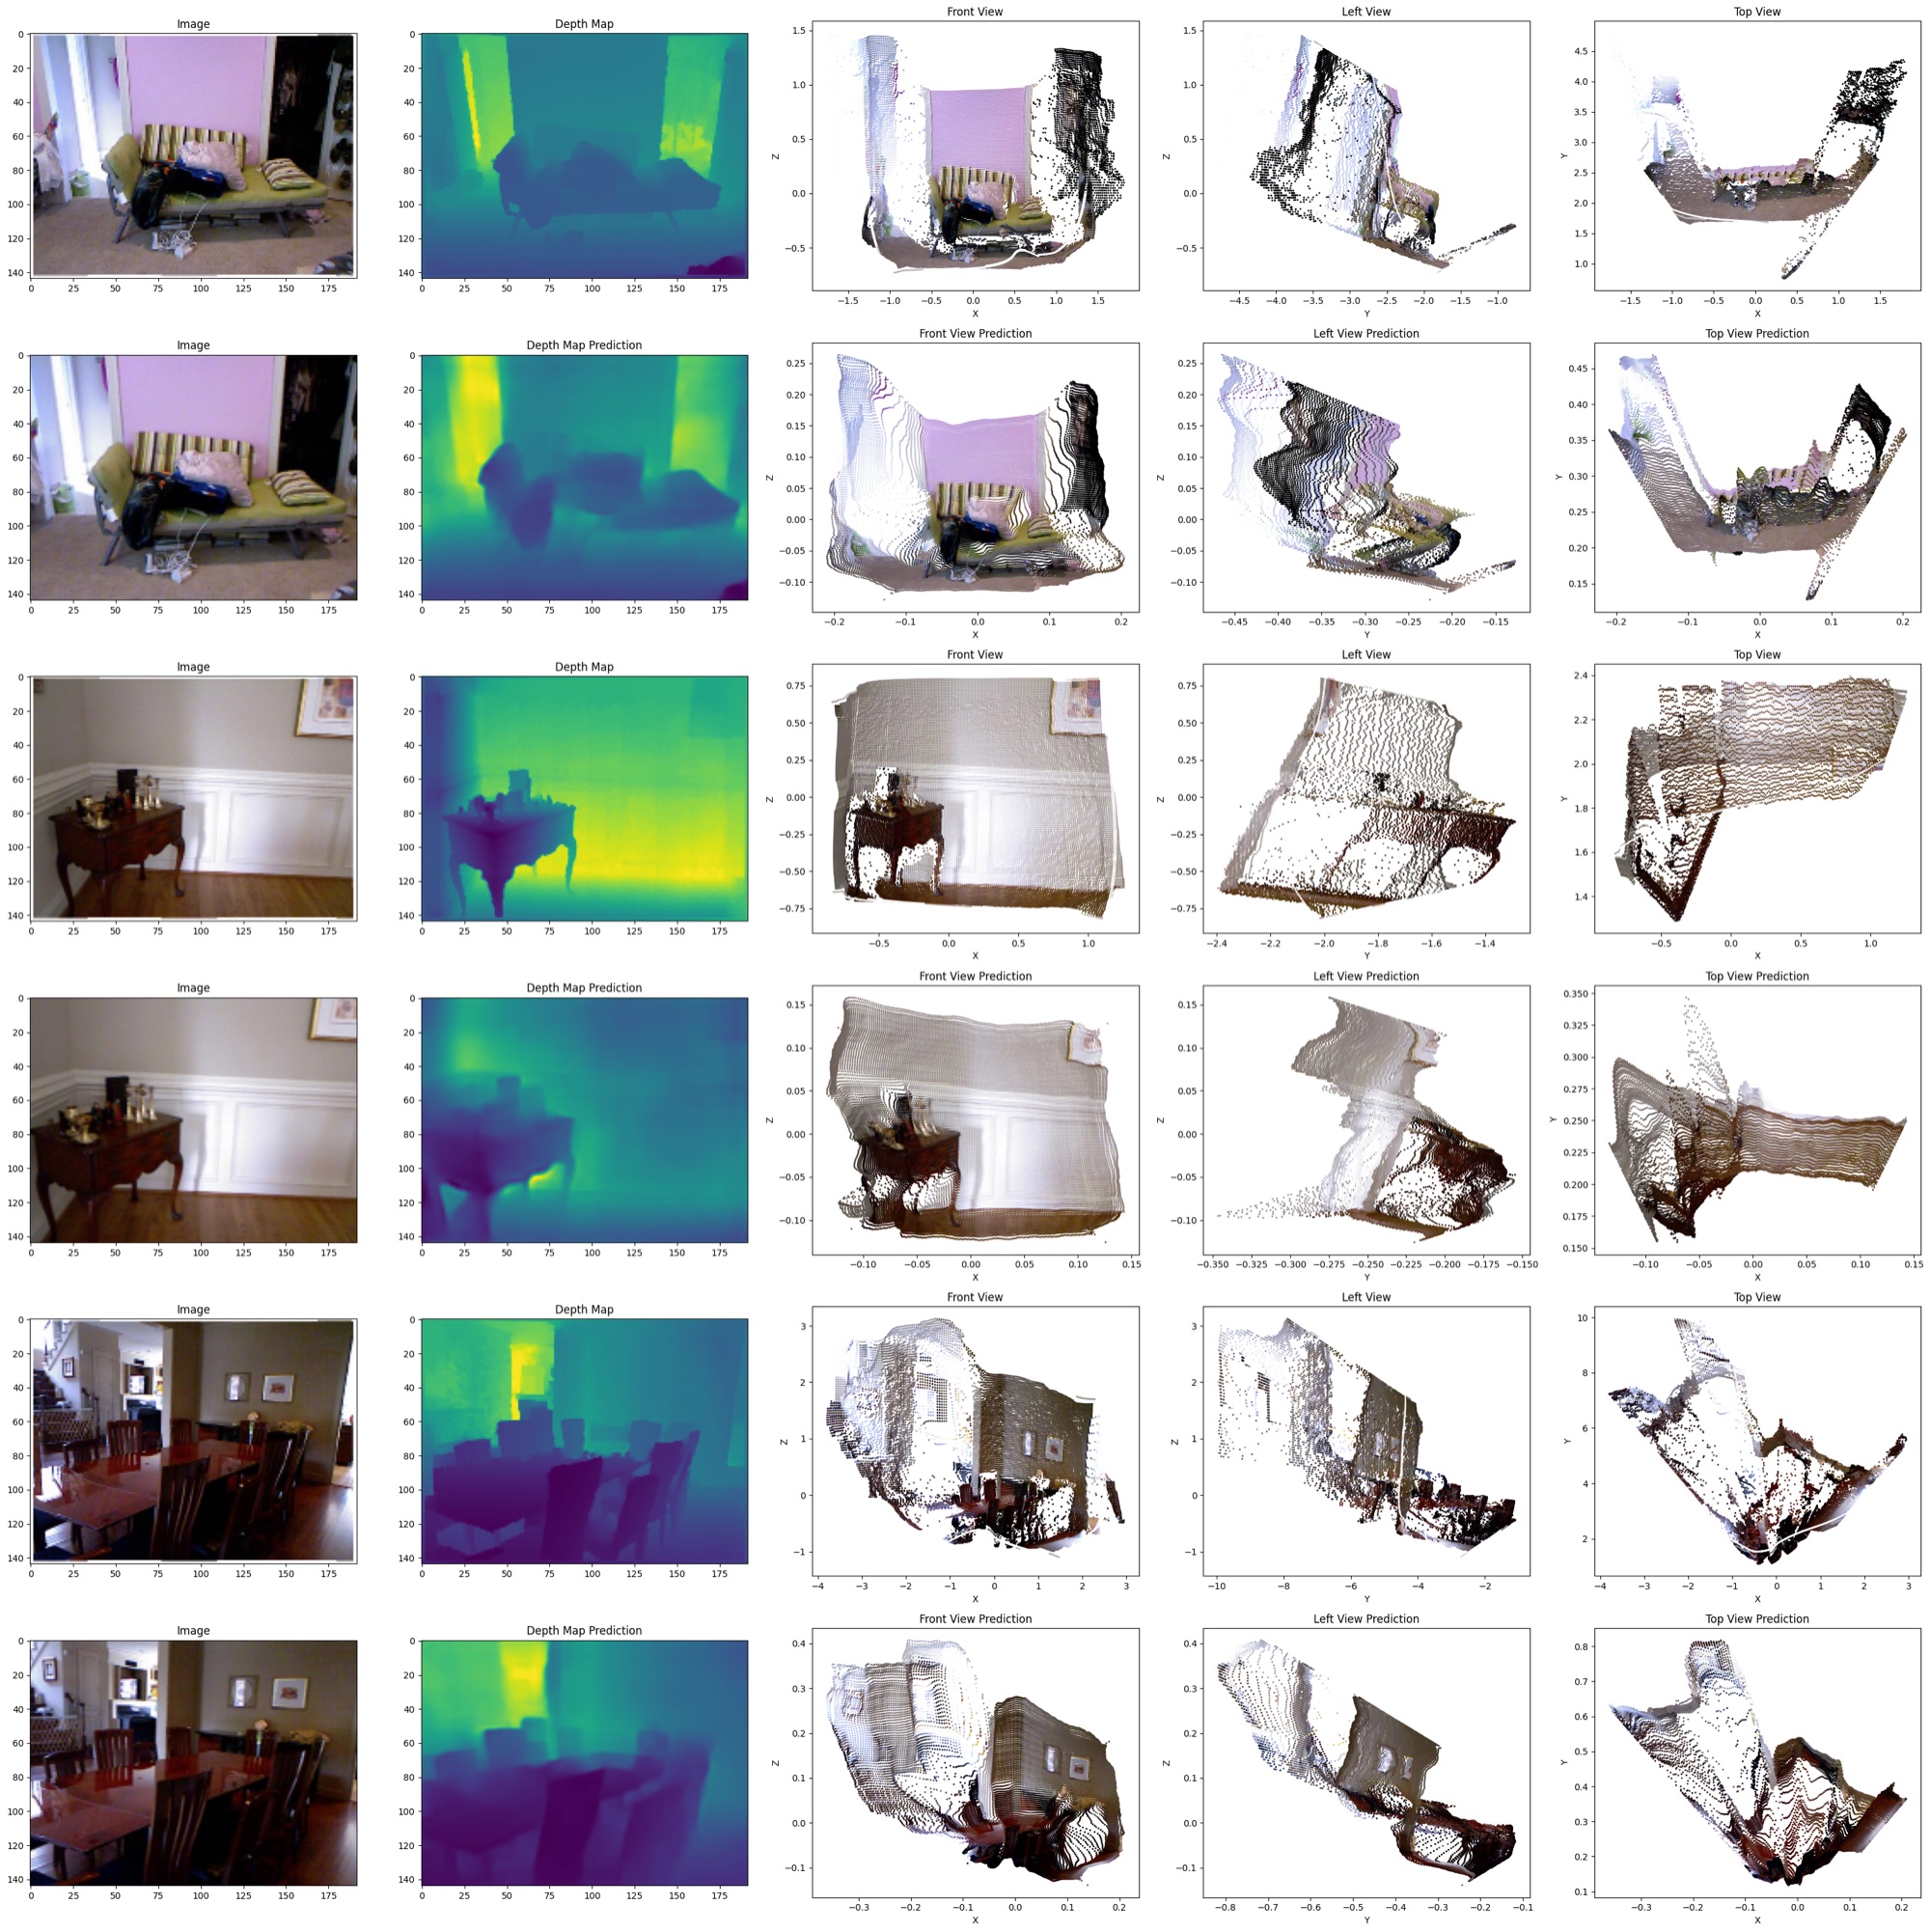
<p>NUY Depth V2 is a large dataset that contains indoor scenes. The following presents some scene examples from the data and different views of the constructed 3D point of these scenes.</p>

<figure class="figure figure-wide">
<img src="/assets/img/NUY_depth_data.jpg" alt="Five scenes from NYU Depth V2. Each row shows the RGB image, its ground-truth depth map, and the 3D point cloud built from them, seen from the front, left and top." loading="lazy" decoding="async" data-zoomable="" />
<figcaption>Five scenes from NYU Depth V2. Each row shows the RGB image, its ground-truth depth map, and the 3D point cloud built from them, seen from the front, left and top.</figcaption>
</figure>

<h2 id="approach-and-architecure">Approach and Architecure</h2>

<p>The objective is to map the image $ I \in\mathbb{R}^{M\times N \times 3}$ to its 3D point cloud $X \in\mathbb{R}^{M\times N \times 3}$ . we can think about a naive or simple autoencoder decoder architecture such as UNET. Where the econder learn the image representation and the decoder map the representation to 3D point cloud. UNET architecture has been tested but it did not give satisfying results.</p>

<p>Our focus will be focus on the camera referential. If we consider the Pinhole camera model, we have the cordinaates $X$, $Y$ and $Z$ depend on the depth map as shown in equation (1).</p>

<p>The idea is instead to learn a mapping function of the image to the 3D point cloud, we will think of a design that estimates the depth map and the camera parameters.</p>

<p>We will follow an approach proposed by Yin et al [6] that has two stages:</p>

<ol>
  <li>
    <p>The first stage is a training a neural network to learn estimating the depth map that will be used to reconstruct a 3D point cloud using standard camera parameters. Not using the correct parameters, precisely, the focal length will result in a distorded point cloud even the global shape is preserved.</p>
  </li>
  <li>
    <p>The second stage then is composed from two networks each take as input a distorded point cloud and estimate either a focal scale or depth shift to restore the distorded 3D point.</p>
  </li>
</ol>

<h2 id="first-stage---depth-estimation">First Stage - Depth Estimation</h2>
<p>For depth map estimation eigen et al [1] introduced a CNN model levereging on multi scale network.This approach involves training a coarse scale network to predict the depth map at global level which is subsequently refined by a secondary network to refine the local regions. Using a multi-scale architecture proven to be effective, Xian et al [7] proposed a multi scale network that use a feature fusion module to fuse features from the encoder and decoder at different scales to obtain finer prediction. Additionnaly to using a multiscale architecture, in Big to Small model [2], the author proposed, under the assumption of locar planar, a local planar guidance module to guide features to the final depth. Unlike other methods which use only skip connection from encoder stage and upsampling to recover the final depth.</p>

<p>We will use BTS model for this task. BTS has an encoder-decoder architecture. The encoder outputs a dense feature map of $H/8$ resolution. The decoding phase consists of $4$ stages. Each stage $k$, (with $k \in {8, 4, 2, 1}$) takes a dense feature map of $H/k$ resolution and apply two operations:</p>
<ol>
  <li>We apply an up-convolution operation to have a feature map of resolution of $2H/k$.</li>
  <li>We apply local planar guidance to produce a coarse depth map $\tilde{c}^{k\times k}$ of resolution $H$ which downsampled using linear interpolation to a resolution of $2H/k$
The output of these two operations are element-wise multiplied and passed through a convolution operation to have the input feature map of resolution $2H/k$ for the next stage.</li>
</ol>

<p>To have the estimated depth map $d$, all the coersed depth map produced by the local planar guidance are used together as follows:</p>

\[d = f(W_1 \tilde{c}^{1 \times 1} + W_2 \tilde{c}^{2\times 2} + W_3 \tilde{c}^{4\times 4} + W_4\tilde{c}^{8\times 8})\]

<p><strong>the LPG module:</strong>  Given a feature map having a spatial resolution $H/k$, it estimates $4D$ plane coefficient for each spatial cell to reconstruct a coarse depth that fit a locally defined $k\times k$ patch on the full resolution. The LPG uses ray-plane intersection to convert each estimated 4D plane coefficient to $k\times k$ local depth cues on the full resolution:</p>

\[c = \frac{n_{4}}{n_{1}u_{i} + n_{2}v_{i} + n_{3}}\]

<p>where $n = (n_{1}, n_{2}, n_{3}, n_{4})$ are the estimated 4D parameters and $(u_{i}, v_{i})$ \are $k\times k$ patch wise normalized coordinate of pixel $i$</p>

<p>The $n$ parameters are the plane parameters where $(n_{1}, n_{2}, n_{3})$ is the normal vector and $n_{4}$ is the distance from the origine to the plane. To estimate these parameters, they use the fact that a normal vector can be computed using two angles, polars and azimuthal, using the the following formulas: (more details in the Appendix)</p>

\[\left\lbrace
\begin{aligned}
&amp; n_{1} = sin(\theta)cos(\phi)\\
&amp; n_{2} = sin(\theta)sin(\phi)\\
&amp; n _{3} = cos(\theta)\\
&amp; n_{4} = d
\end{aligned}
\right.\]

<p>To estimates these three parameters at the scale $H/k$, the LPG takes as input the feature of the previous fusion module, i.e feature at scale $H/2k$, and pass them through a series of $1\times1$ convolution to reduce the number of channels by a factor of $2$ until it reaches $3$. So the final convolution layer of the LPG estimates $\theta$, $\phi$ and $d$. More details about the computation are in the implementation of this module.
Thus using the LPG, we have an estimation of depth map at different scales. The lower scales learns the global shapes and the higher scales learns local details. 
The final depth is estimated through a convolution that takes all the depth map at each scale</p>

<h2 id="focal-length-and-depth-shift-estimation">focal length and depth shift estimation</h2>

<p>The input distorded point cloud are created as follows:</p>
<ol>
  <li>for the first network, we shift the depth map by a value drawn from a uniform distribution. The shift will result in a distorded shape as it will affect non uniformly, the X, Y, and Z. So, the goal of the first network is to estimate the depth shift value.</li>
  <li>For the second network, the distortion is created by scaling the focal length by a coefficient drawn from a uniform distribution. This scaling will affect only X and Y and will results in points far from each other or closer to each other.</li>
</ol>

<p>to estimate the depth shift and focal length shift. As in [6] we have neural network based on PointNet to predict the depth shift or focal length shift given a input of distorted point cloud:</p>

\[L_{depth\ shift} = min_{\theta} |N_d(F(u_0, v_0, f^{*}, d^{*} + ∆^{*}_d), \theta) − ∆^{*}_d|\]

<p>where \(\Delta^{*}_d\) is drawn from a uniform distribution \(\text{Uniform}(-0.25, 0.8)\) during training</p>

\[L_{focal\ scale} = min_{\theta} |N_d(F(u_0, v_0, \alpha^{*}f^{*}, d^{*}), \theta) − \alpha^{*}|\]

<p>where \(\alpha^{*}\) is drawn from a uniform distribution \(\text{Uniform}(0.6, 1.25)\) during training</p>

<p>The network used for focal scale estimation and depth shift estimation is a PoinNet [9] applied for regression task. The network takes as input a 3D point cloud (B, N, 3) and apply an <strong>input transformation block</strong> followed by a 1D conv layer to extract features. A <strong>feature transformation block</strong> is applied on the extracted and followed by a series of 1D conv operation to result in a vector of global feature using a max aggregation. The max pooling is used to have invariance w.t.r point cloud order.
The  <strong>input transformation block</strong> and  <strong>feature transformation block</strong>  contains a series of conv and linear operations and use relu as activation function and max pooling to aggregates information. The transormation block is used to transform the point cloud to a canonical form to have invariance w.r.t to transformation.</p>

<h2 id="loss-and-metrics">Loss and Metrics</h2>

<p>The depth estimation, focal length scale estimation or depth shift estimation are regression task. For the loss will be based of L1 or MSE loss 
In depth estimation many losses function have been proposed in the literature such as Huber Loss, silog loss, ordinal regression loss. In our case, we will use scale invariance log which computes the error between the ground truth and the prediction without taking into account the scale discrepency.So, it consider only the relative error between the values.</p>

\[L(\hat{d}, d) = \frac{1}{n}\sum_{p}{||ln(d^{*}_{p}) - ln(d_{p})||^{2}} - \frac{1}{n^{2}}(\sum_{p}{(ln(d^{*}_{p}) - ln(d_{p}))})^{2}\]

<p>for evaluation we consider the following metrics used in the literature:</p>

<ul>
  <li>
    <p><strong>Accuracy under a threshold</strong> $\delta$ % of \(p  :  \delta = max(\frac{\hat{d}_p}{d_p}, \frac{d_p}{\hat{d}_p}) &lt; threshold\)</p>
  </li>
  <li>
    <p><strong>Abs. Rel.:</strong> Mean Absolute Value of the Relative Error. 
\(\frac{1}{T} \sum_{p \in T} \left| \frac{d_p - \hat{d}_p}{d_p} \right|\)</p>
  </li>
</ul>

<h2 id="data-preparation">Data Preparation</h2>

<p>The NUY depth dataset is handled respectively by <code class="language-plaintext highlighter-rouge">NUYDepth</code> class that stores samples of images, depth map for training depth map network and point cloud with depth shift or focal scale for PointNet networks. The class contains the method</p>
<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">_generate_point_cloud</span><span class="p">():</span>
</code></pre></div></div>
<p>which generate a point cloud using Pinhol camera model.</p>

<p>The image and depth map are resized to (256, 256) for computational reasons in the case we are training for depth map estimation. For depth shift or focal scale estimation, we keep the full resolution of the depth map to construct the 3D point cloud, but we use only a sample of 4096 points for for computational reasons.</p>

<p>The images are normalized using mean and std. We use data augmentation, flipping and brightness adjusting as we are using only a subset of 1300 image from the data The original data has 490GB.</p>

<h2 id="implementation">Implementation</h2>

<p>Here the implementation of the models, datasets and training loops. The results discussion are right after the following cells.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">torch</span>
<span class="kn">import</span> <span class="n">torch.nn</span> <span class="k">as</span> <span class="n">nn</span>
<span class="kn">import</span> <span class="n">torch.nn.functional</span> <span class="k">as</span> <span class="n">torch_nn_func</span>
<span class="kn">import</span> <span class="n">math</span>

<span class="kn">from</span> <span class="n">collections</span> <span class="kn">import</span> <span class="n">namedtuple</span>

<span class="c1"># This sets the batch norm layers in pytorch as if {'is_training': False, 'scale': True} in tensorflow
</span><span class="k">def</span> <span class="nf">bn_init_as_tf</span><span class="p">(</span><span class="n">m</span><span class="p">):</span>
    <span class="k">if</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">m</span><span class="p">,</span> <span class="n">nn</span><span class="p">.</span><span class="n">BatchNorm2d</span><span class="p">):</span>
        <span class="n">m</span><span class="p">.</span><span class="n">track_running_stats</span> <span class="o">=</span> <span class="bp">True</span>  <span class="c1"># These two lines enable using stats (moving mean and var) loaded from pretrained model
</span>        <span class="n">m</span><span class="p">.</span><span class="nf">eval</span><span class="p">()</span>                      <span class="c1"># or zero mean and variance of one if the batch norm layer has no pretrained values
</span>        <span class="n">m</span><span class="p">.</span><span class="n">affine</span> <span class="o">=</span> <span class="bp">True</span>
        <span class="n">m</span><span class="p">.</span><span class="n">requires_grad</span> <span class="o">=</span> <span class="bp">True</span>


<span class="k">def</span> <span class="nf">weights_init_xavier</span><span class="p">(</span><span class="n">m</span><span class="p">):</span>
    <span class="k">if</span> <span class="nf">isinstance</span><span class="p">(</span><span class="n">m</span><span class="p">,</span> <span class="n">nn</span><span class="p">.</span><span class="n">Conv2d</span><span class="p">):</span>
        <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">xavier_uniform_</span><span class="p">(</span><span class="n">m</span><span class="p">.</span><span class="n">weight</span><span class="p">)</span>
        <span class="k">if</span> <span class="n">m</span><span class="p">.</span><span class="n">bias</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
            <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="n">init</span><span class="p">.</span><span class="nf">zeros_</span><span class="p">(</span><span class="n">m</span><span class="p">.</span><span class="n">bias</span><span class="p">)</span>
            

<span class="k">class</span> <span class="nc">silog_loss</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">variance_focus</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">(</span><span class="n">silog_loss</span><span class="p">,</span> <span class="n">self</span><span class="p">).</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">variance_focus</span> <span class="o">=</span> <span class="n">variance_focus</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">depth_est</span><span class="p">,</span> <span class="n">depth_gt</span><span class="p">,</span> <span class="n">mask</span><span class="p">):</span>
        <span class="n">d</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">log</span><span class="p">(</span><span class="n">depth_est</span><span class="p">[</span><span class="n">mask</span><span class="p">])</span> <span class="o">-</span> <span class="n">torch</span><span class="p">.</span><span class="nf">log</span><span class="p">(</span><span class="n">depth_gt</span><span class="p">[</span><span class="n">mask</span><span class="p">])</span>
        <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">((</span><span class="n">d</span> <span class="o">**</span> <span class="mi">2</span><span class="p">).</span><span class="nf">mean</span><span class="p">()</span> <span class="o">-</span> <span class="n">self</span><span class="p">.</span><span class="n">variance_focus</span> <span class="o">*</span> <span class="p">(</span><span class="n">d</span><span class="p">.</span><span class="nf">mean</span><span class="p">()</span> <span class="o">**</span> <span class="mi">2</span><span class="p">))</span> <span class="o">*</span> <span class="mf">10.0</span>


<span class="k">class</span> <span class="nc">atrous_conv</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Sequential</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">in_channels</span><span class="p">,</span> <span class="n">out_channels</span><span class="p">,</span> <span class="n">dilation</span><span class="p">,</span> <span class="n">apply_bn_first</span><span class="o">=</span><span class="bp">True</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">(</span><span class="n">atrous_conv</span><span class="p">,</span> <span class="n">self</span><span class="p">).</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">atrous_conv</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="nc">Sequential</span><span class="p">()</span>
        <span class="k">if</span> <span class="n">apply_bn_first</span><span class="p">:</span>
            <span class="n">self</span><span class="p">.</span><span class="n">atrous_conv</span><span class="p">.</span><span class="nf">add_module</span><span class="p">(</span><span class="sh">'</span><span class="s">first_bn</span><span class="sh">'</span><span class="p">,</span> <span class="n">nn</span><span class="p">.</span><span class="nc">BatchNorm2d</span><span class="p">(</span><span class="n">in_channels</span><span class="p">,</span> <span class="n">momentum</span><span class="o">=</span><span class="mf">0.01</span><span class="p">,</span> <span class="n">affine</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">track_running_stats</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="mf">1.1e-5</span><span class="p">))</span>
        
        <span class="n">self</span><span class="p">.</span><span class="n">atrous_conv</span><span class="p">.</span><span class="nf">add_module</span><span class="p">(</span><span class="sh">'</span><span class="s">aconv_sequence</span><span class="sh">'</span><span class="p">,</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Sequential</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="nc">ReLU</span><span class="p">(),</span>
                                                                    <span class="n">nn</span><span class="p">.</span><span class="nc">Conv2d</span><span class="p">(</span><span class="n">in_channels</span><span class="o">=</span><span class="n">in_channels</span><span class="p">,</span> <span class="n">out_channels</span><span class="o">=</span><span class="n">out_channels</span><span class="o">*</span><span class="mi">2</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">kernel_size</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">stride</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="mi">0</span><span class="p">),</span>
                                                                    <span class="n">nn</span><span class="p">.</span><span class="nc">BatchNorm2d</span><span class="p">(</span><span class="n">out_channels</span><span class="o">*</span><span class="mi">2</span><span class="p">,</span> <span class="n">momentum</span><span class="o">=</span><span class="mf">0.01</span><span class="p">,</span> <span class="n">affine</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">track_running_stats</span><span class="o">=</span><span class="bp">True</span><span class="p">),</span>
                                                                    <span class="n">nn</span><span class="p">.</span><span class="nc">ReLU</span><span class="p">(),</span>
                                                                    <span class="n">nn</span><span class="p">.</span><span class="nc">Conv2d</span><span class="p">(</span><span class="n">in_channels</span><span class="o">=</span><span class="n">out_channels</span> <span class="o">*</span> <span class="mi">2</span><span class="p">,</span> <span class="n">out_channels</span><span class="o">=</span><span class="n">out_channels</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">kernel_size</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span> <span class="n">stride</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span>
                                                                              <span class="n">padding</span><span class="o">=</span><span class="p">(</span><span class="n">dilation</span><span class="p">,</span> <span class="n">dilation</span><span class="p">),</span> <span class="n">dilation</span><span class="o">=</span><span class="n">dilation</span><span class="p">)))</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="n">atrous_conv</span><span class="p">.</span><span class="nf">forward</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
    

<span class="k">class</span> <span class="nc">upconv</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">in_channels</span><span class="p">,</span> <span class="n">out_channels</span><span class="p">,</span> <span class="n">ratio</span><span class="o">=</span><span class="mi">2</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">(</span><span class="n">upconv</span><span class="p">,</span> <span class="n">self</span><span class="p">).</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">elu</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">ELU</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">conv</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Conv2d</span><span class="p">(</span><span class="n">in_channels</span><span class="o">=</span><span class="n">in_channels</span><span class="p">,</span> <span class="n">out_channels</span><span class="o">=</span><span class="n">out_channels</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">kernel_size</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span> <span class="n">stride</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">ratio</span> <span class="o">=</span> <span class="n">ratio</span>
        
    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">up_x</span> <span class="o">=</span> <span class="n">torch_nn_func</span><span class="p">.</span><span class="nf">interpolate</span><span class="p">(</span><span class="n">x</span><span class="p">,</span> <span class="n">scale_factor</span><span class="o">=</span><span class="n">self</span><span class="p">.</span><span class="n">ratio</span><span class="p">,</span> <span class="n">mode</span><span class="o">=</span><span class="sh">'</span><span class="s">nearest</span><span class="sh">'</span><span class="p">)</span>
        <span class="n">out</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">conv</span><span class="p">(</span><span class="n">up_x</span><span class="p">)</span>
        <span class="n">out</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">elu</span><span class="p">(</span><span class="n">out</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">out</span>


<span class="k">class</span> <span class="nc">reduction_1x1</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Sequential</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">num_in_filters</span><span class="p">,</span> <span class="n">num_out_filters</span><span class="p">,</span> <span class="n">max_depth</span><span class="p">,</span> <span class="n">is_final</span><span class="o">=</span><span class="bp">False</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">(</span><span class="n">reduction_1x1</span><span class="p">,</span> <span class="n">self</span><span class="p">).</span><span class="nf">__init__</span><span class="p">()</span>        
        <span class="n">self</span><span class="p">.</span><span class="n">max_depth</span> <span class="o">=</span> <span class="n">max_depth</span>
        <span class="n">self</span><span class="p">.</span><span class="n">is_final</span> <span class="o">=</span> <span class="n">is_final</span>
        <span class="n">self</span><span class="p">.</span><span class="n">sigmoid</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Sigmoid</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">reduc</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="nc">Sequential</span><span class="p">()</span>
        
        <span class="k">while</span> <span class="n">num_out_filters</span> <span class="o">&gt;=</span> <span class="mi">4</span><span class="p">:</span>
            <span class="k">if</span> <span class="n">num_out_filters</span> <span class="o">&lt;</span> <span class="mi">8</span><span class="p">:</span>
                <span class="k">if</span> <span class="n">self</span><span class="p">.</span><span class="n">is_final</span><span class="p">:</span>
                    <span class="n">self</span><span class="p">.</span><span class="n">reduc</span><span class="p">.</span><span class="nf">add_module</span><span class="p">(</span><span class="sh">'</span><span class="s">final</span><span class="sh">'</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="nc">Sequential</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="nc">Conv2d</span><span class="p">(</span><span class="n">num_in_filters</span><span class="p">,</span> <span class="n">out_channels</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span>
                                                                                 <span class="n">kernel_size</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">stride</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="mi">0</span><span class="p">),</span>
                                                                       <span class="n">nn</span><span class="p">.</span><span class="nc">Sigmoid</span><span class="p">()))</span>
                <span class="k">else</span><span class="p">:</span>
                    <span class="n">self</span><span class="p">.</span><span class="n">reduc</span><span class="p">.</span><span class="nf">add_module</span><span class="p">(</span><span class="sh">'</span><span class="s">plane_params</span><span class="sh">'</span><span class="p">,</span> <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="nc">Conv2d</span><span class="p">(</span><span class="n">num_in_filters</span><span class="p">,</span> <span class="n">out_channels</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span>
                                                                          <span class="n">kernel_size</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">stride</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="mi">0</span><span class="p">))</span>
                <span class="k">break</span>
            <span class="k">else</span><span class="p">:</span>
                <span class="n">self</span><span class="p">.</span><span class="n">reduc</span><span class="p">.</span><span class="nf">add_module</span><span class="p">(</span><span class="sh">'</span><span class="s">inter_{}_{}</span><span class="sh">'</span><span class="p">.</span><span class="nf">format</span><span class="p">(</span><span class="n">num_in_filters</span><span class="p">,</span> <span class="n">num_out_filters</span><span class="p">),</span>
                                      <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="nc">Sequential</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="nc">Conv2d</span><span class="p">(</span><span class="n">in_channels</span><span class="o">=</span><span class="n">num_in_filters</span><span class="p">,</span> <span class="n">out_channels</span><span class="o">=</span><span class="n">num_out_filters</span><span class="p">,</span>
                                                                    <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">,</span> <span class="n">kernel_size</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">stride</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">padding</span><span class="o">=</span><span class="mi">0</span><span class="p">),</span>
                                                          <span class="n">nn</span><span class="p">.</span><span class="nc">ELU</span><span class="p">()))</span>

            <span class="n">num_in_filters</span> <span class="o">=</span> <span class="n">num_out_filters</span>
            <span class="n">num_out_filters</span> <span class="o">=</span> <span class="n">num_out_filters</span> <span class="o">//</span> <span class="mi">2</span>
    
    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">net</span><span class="p">):</span>
        <span class="n">net</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">reduc</span><span class="p">.</span><span class="nf">forward</span><span class="p">(</span><span class="n">net</span><span class="p">)</span>
        <span class="k">if</span> <span class="ow">not</span> <span class="n">self</span><span class="p">.</span><span class="n">is_final</span><span class="p">:</span>
            <span class="n">theta</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">sigmoid</span><span class="p">(</span><span class="n">net</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">,</span> <span class="p">:,</span> <span class="p">:])</span> <span class="o">*</span> <span class="n">math</span><span class="p">.</span><span class="n">pi</span> <span class="o">/</span> <span class="mi">3</span>
            <span class="n">phi</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">sigmoid</span><span class="p">(</span><span class="n">net</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">,</span> <span class="p">:,</span> <span class="p">:])</span> <span class="o">*</span> <span class="n">math</span><span class="p">.</span><span class="n">pi</span> <span class="o">*</span> <span class="mi">2</span>
            <span class="n">dist</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">sigmoid</span><span class="p">(</span><span class="n">net</span><span class="p">[:,</span> <span class="mi">2</span><span class="p">,</span> <span class="p">:,</span> <span class="p">:])</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="n">max_depth</span>
            <span class="n">n1</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">mul</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">sin</span><span class="p">(</span><span class="n">theta</span><span class="p">),</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cos</span><span class="p">(</span><span class="n">phi</span><span class="p">)).</span><span class="nf">unsqueeze</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span>
            <span class="n">n2</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">mul</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">sin</span><span class="p">(</span><span class="n">theta</span><span class="p">),</span> <span class="n">torch</span><span class="p">.</span><span class="nf">sin</span><span class="p">(</span><span class="n">phi</span><span class="p">)).</span><span class="nf">unsqueeze</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span>
            <span class="n">n3</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cos</span><span class="p">(</span><span class="n">theta</span><span class="p">).</span><span class="nf">unsqueeze</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span>
            <span class="n">n4</span> <span class="o">=</span> <span class="n">dist</span><span class="p">.</span><span class="nf">unsqueeze</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span>
            <span class="n">net</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">n1</span><span class="p">,</span> <span class="n">n2</span><span class="p">,</span> <span class="n">n3</span><span class="p">,</span> <span class="n">n4</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        
        <span class="k">return</span> <span class="n">net</span>

<span class="k">class</span> <span class="nc">local_planar_guidance</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">upratio</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">(</span><span class="n">local_planar_guidance</span><span class="p">,</span> <span class="n">self</span><span class="p">).</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">upratio</span> <span class="o">=</span> <span class="n">upratio</span>
        <span class="n">self</span><span class="p">.</span><span class="n">u</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">upratio</span><span class="p">).</span><span class="nf">reshape</span><span class="p">([</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">upratio</span><span class="p">]).</span><span class="nf">float</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">v</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="nf">int</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">upratio</span><span class="p">)).</span><span class="nf">reshape</span><span class="p">([</span><span class="mi">1</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">upratio</span><span class="p">,</span> <span class="mi">1</span><span class="p">]).</span><span class="nf">float</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">upratio</span> <span class="o">=</span> <span class="nf">float</span><span class="p">(</span><span class="n">upratio</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">plane_eq</span><span class="p">,</span> <span class="n">focal</span><span class="p">):</span>
        <span class="n">plane_eq_expanded</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">repeat_interleave</span><span class="p">(</span><span class="n">plane_eq</span><span class="p">,</span> <span class="nf">int</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">upratio</span><span class="p">),</span> <span class="mi">2</span><span class="p">)</span>
        <span class="n">plane_eq_expanded</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">repeat_interleave</span><span class="p">(</span><span class="n">plane_eq_expanded</span><span class="p">,</span> <span class="nf">int</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">upratio</span><span class="p">),</span> <span class="mi">3</span><span class="p">)</span>
        <span class="n">n1</span> <span class="o">=</span> <span class="n">plane_eq_expanded</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">,</span> <span class="p">:,</span> <span class="p">:]</span>
        <span class="n">n2</span> <span class="o">=</span> <span class="n">plane_eq_expanded</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">,</span> <span class="p">:,</span> <span class="p">:]</span>
        <span class="n">n3</span> <span class="o">=</span> <span class="n">plane_eq_expanded</span><span class="p">[:,</span> <span class="mi">2</span><span class="p">,</span> <span class="p">:,</span> <span class="p">:]</span>
        <span class="n">n4</span> <span class="o">=</span> <span class="n">plane_eq_expanded</span><span class="p">[:,</span> <span class="mi">3</span><span class="p">,</span> <span class="p">:,</span> <span class="p">:]</span>
        
        <span class="n">u</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">u</span><span class="p">.</span><span class="nf">repeat</span><span class="p">(</span><span class="n">plane_eq</span><span class="p">.</span><span class="nf">size</span><span class="p">(</span><span class="mi">0</span><span class="p">),</span> <span class="n">plane_eq</span><span class="p">.</span><span class="nf">size</span><span class="p">(</span><span class="mi">2</span><span class="p">)</span> <span class="o">*</span> <span class="nf">int</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">upratio</span><span class="p">),</span> <span class="n">plane_eq</span><span class="p">.</span><span class="nf">size</span><span class="p">(</span><span class="mi">3</span><span class="p">))</span><span class="c1">#.cuda()
</span>        <span class="n">u</span> <span class="o">=</span> <span class="p">(</span><span class="n">u</span> <span class="o">-</span> <span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">upratio</span> <span class="o">-</span> <span class="mi">1</span><span class="p">)</span> <span class="o">*</span> <span class="mf">0.5</span><span class="p">)</span> <span class="o">/</span> <span class="n">self</span><span class="p">.</span><span class="n">upratio</span>
        
        <span class="n">v</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">v</span><span class="p">.</span><span class="nf">repeat</span><span class="p">(</span><span class="n">plane_eq</span><span class="p">.</span><span class="nf">size</span><span class="p">(</span><span class="mi">0</span><span class="p">),</span> <span class="n">plane_eq</span><span class="p">.</span><span class="nf">size</span><span class="p">(</span><span class="mi">2</span><span class="p">),</span> <span class="n">plane_eq</span><span class="p">.</span><span class="nf">size</span><span class="p">(</span><span class="mi">3</span><span class="p">)</span> <span class="o">*</span> <span class="nf">int</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">upratio</span><span class="p">))</span><span class="c1">#.cuda()
</span>        <span class="n">v</span> <span class="o">=</span> <span class="p">(</span><span class="n">v</span> <span class="o">-</span> <span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">upratio</span> <span class="o">-</span> <span class="mi">1</span><span class="p">)</span> <span class="o">*</span> <span class="mf">0.5</span><span class="p">)</span> <span class="o">/</span> <span class="n">self</span><span class="p">.</span><span class="n">upratio</span>

        <span class="k">return</span> <span class="n">n4</span> <span class="o">/</span> <span class="p">(</span><span class="n">n1</span> <span class="o">*</span> <span class="n">u</span> <span class="o">+</span> <span class="n">n2</span> <span class="o">*</span> <span class="n">v</span> <span class="o">+</span> <span class="n">n3</span><span class="p">)</span>

<span class="k">class</span> <span class="nc">bts</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">feat_out_channels</span><span class="p">,</span> <span class="n">num_features</span><span class="o">=</span><span class="mi">512</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">(</span><span class="n">bts</span><span class="p">,</span> <span class="n">self</span><span class="p">).</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">max_depth</span> <span class="o">=</span> <span class="mf">1.</span>
        <span class="n">self</span><span class="p">.</span><span class="n">upconv5</span>    <span class="o">=</span> <span class="nf">upconv</span><span class="p">(</span><span class="n">feat_out_channels</span><span class="p">[</span><span class="mi">4</span><span class="p">],</span> <span class="n">num_features</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">bn5</span>        <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">BatchNorm2d</span><span class="p">(</span><span class="n">num_features</span><span class="p">,</span> <span class="n">momentum</span><span class="o">=</span><span class="mf">0.01</span><span class="p">,</span> <span class="n">affine</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="mf">1.1e-5</span><span class="p">)</span>
        
        <span class="n">self</span><span class="p">.</span><span class="n">conv5</span>      <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="nc">Sequential</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="nc">Conv2d</span><span class="p">(</span><span class="n">num_features</span> <span class="o">+</span> <span class="n">feat_out_channels</span><span class="p">[</span><span class="mi">3</span><span class="p">],</span> <span class="n">num_features</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">),</span>
                                              <span class="n">nn</span><span class="p">.</span><span class="nc">ELU</span><span class="p">())</span>
        <span class="n">self</span><span class="p">.</span><span class="n">upconv4</span>    <span class="o">=</span> <span class="nf">upconv</span><span class="p">(</span><span class="n">num_features</span><span class="p">,</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">2</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">bn4</span>        <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">BatchNorm2d</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">2</span><span class="p">,</span> <span class="n">momentum</span><span class="o">=</span><span class="mf">0.01</span><span class="p">,</span> <span class="n">affine</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="mf">1.1e-5</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">conv4</span>      <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="nc">Sequential</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="nc">Conv2d</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">2</span> <span class="o">+</span> <span class="n">feat_out_channels</span><span class="p">[</span><span class="mi">2</span><span class="p">],</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">),</span>
                                              <span class="n">nn</span><span class="p">.</span><span class="nc">ELU</span><span class="p">())</span>
        <span class="n">self</span><span class="p">.</span><span class="n">bn4_2</span>      <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">BatchNorm2d</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">2</span><span class="p">,</span> <span class="n">momentum</span><span class="o">=</span><span class="mf">0.01</span><span class="p">,</span> <span class="n">affine</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="mf">1.1e-5</span><span class="p">)</span>
        
        <span class="n">self</span><span class="p">.</span><span class="n">daspp_3</span>    <span class="o">=</span> <span class="nf">atrous_conv</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">2</span><span class="p">,</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="n">apply_bn_first</span><span class="o">=</span><span class="bp">False</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">daspp_6</span>    <span class="o">=</span> <span class="nf">atrous_conv</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">2</span> <span class="o">+</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span> <span class="o">+</span> <span class="n">feat_out_channels</span><span class="p">[</span><span class="mi">2</span><span class="p">],</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span><span class="p">,</span> <span class="mi">6</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">daspp_12</span>   <span class="o">=</span> <span class="nf">atrous_conv</span><span class="p">(</span><span class="n">num_features</span> <span class="o">+</span> <span class="n">feat_out_channels</span><span class="p">[</span><span class="mi">2</span><span class="p">],</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span><span class="p">,</span> <span class="mi">12</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">daspp_18</span>   <span class="o">=</span> <span class="nf">atrous_conv</span><span class="p">(</span><span class="n">num_features</span> <span class="o">+</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span> <span class="o">+</span> <span class="n">feat_out_channels</span><span class="p">[</span><span class="mi">2</span><span class="p">],</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span><span class="p">,</span> <span class="mi">18</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">daspp_24</span>   <span class="o">=</span> <span class="nf">atrous_conv</span><span class="p">(</span><span class="n">num_features</span> <span class="o">+</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">2</span> <span class="o">+</span> <span class="n">feat_out_channels</span><span class="p">[</span><span class="mi">2</span><span class="p">],</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span><span class="p">,</span> <span class="mi">24</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">daspp_conv</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="nc">Sequential</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="nc">Conv2d</span><span class="p">(</span><span class="n">num_features</span> <span class="o">+</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">2</span> <span class="o">+</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span><span class="p">,</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">),</span>
                                              <span class="n">nn</span><span class="p">.</span><span class="nc">ELU</span><span class="p">())</span>
        <span class="n">self</span><span class="p">.</span><span class="n">reduc8x8</span>   <span class="o">=</span> <span class="nf">reduction_1x1</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span><span class="p">,</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">max_depth</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">lpg8x8</span>     <span class="o">=</span> <span class="nf">local_planar_guidance</span><span class="p">(</span><span class="mi">8</span><span class="p">)</span>
        
        <span class="n">self</span><span class="p">.</span><span class="n">upconv3</span>    <span class="o">=</span> <span class="nf">upconv</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span><span class="p">,</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">bn3</span>        <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">BatchNorm2d</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span><span class="p">,</span> <span class="n">momentum</span><span class="o">=</span><span class="mf">0.01</span><span class="p">,</span> <span class="n">affine</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="mf">1.1e-5</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">conv3</span>      <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="nc">Sequential</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="nc">Conv2d</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span> <span class="o">+</span> <span class="n">feat_out_channels</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span> <span class="o">+</span> <span class="mi">1</span><span class="p">,</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">),</span>
                                              <span class="n">nn</span><span class="p">.</span><span class="nc">ELU</span><span class="p">())</span>
        <span class="n">self</span><span class="p">.</span><span class="n">reduc4x4</span>   <span class="o">=</span> <span class="nf">reduction_1x1</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span><span class="p">,</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">8</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">max_depth</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">lpg4x4</span>     <span class="o">=</span> <span class="nf">local_planar_guidance</span><span class="p">(</span><span class="mi">4</span><span class="p">)</span>
        
        <span class="n">self</span><span class="p">.</span><span class="n">upconv2</span>    <span class="o">=</span> <span class="nf">upconv</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">4</span><span class="p">,</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">8</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">bn2</span>        <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">BatchNorm2d</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">8</span><span class="p">,</span> <span class="n">momentum</span><span class="o">=</span><span class="mf">0.01</span><span class="p">,</span> <span class="n">affine</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="n">eps</span><span class="o">=</span><span class="mf">1.1e-5</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">conv2</span>      <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="nc">Sequential</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="nc">Conv2d</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">8</span> <span class="o">+</span> <span class="n">feat_out_channels</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span> <span class="o">+</span> <span class="mi">1</span><span class="p">,</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">8</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">),</span>
                                              <span class="n">nn</span><span class="p">.</span><span class="nc">ELU</span><span class="p">())</span>
        
        <span class="n">self</span><span class="p">.</span><span class="n">reduc2x2</span>   <span class="o">=</span> <span class="nf">reduction_1x1</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">8</span><span class="p">,</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">16</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">max_depth</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">lpg2x2</span>     <span class="o">=</span> <span class="nf">local_planar_guidance</span><span class="p">(</span><span class="mi">2</span><span class="p">)</span>
        
        <span class="n">self</span><span class="p">.</span><span class="n">upconv1</span>    <span class="o">=</span> <span class="nf">upconv</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">8</span><span class="p">,</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">16</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">reduc1x1</span>   <span class="o">=</span> <span class="nf">reduction_1x1</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">16</span><span class="p">,</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">32</span><span class="p">,</span> <span class="n">self</span><span class="p">.</span><span class="n">max_depth</span><span class="p">,</span> <span class="n">is_final</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">conv1</span>      <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="nc">Sequential</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="nc">Conv2d</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">16</span> <span class="o">+</span> <span class="mi">4</span><span class="p">,</span> <span class="n">num_features</span> <span class="o">//</span> <span class="mi">16</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">),</span>
                                              <span class="n">nn</span><span class="p">.</span><span class="nc">ELU</span><span class="p">())</span>
        <span class="n">self</span><span class="p">.</span><span class="n">get_depth</span>  <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="nc">Sequential</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="nc">Conv2d</span><span class="p">(</span><span class="n">num_features</span> <span class="o">//</span> <span class="mi">16</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="n">bias</span><span class="o">=</span><span class="bp">False</span><span class="p">),</span>
                                              <span class="n">nn</span><span class="p">.</span><span class="nc">Sigmoid</span><span class="p">())</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">features</span><span class="p">,</span> <span class="n">focal</span><span class="p">):</span>
        <span class="n">skip0</span><span class="p">,</span> <span class="n">skip1</span><span class="p">,</span> <span class="n">skip2</span><span class="p">,</span> <span class="n">skip3</span> <span class="o">=</span> <span class="n">features</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">features</span><span class="p">[</span><span class="mi">1</span><span class="p">],</span> <span class="n">features</span><span class="p">[</span><span class="mi">2</span><span class="p">],</span> <span class="n">features</span><span class="p">[</span><span class="mi">3</span><span class="p">]</span>
        <span class="n">dense_features</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="n">nn</span><span class="p">.</span><span class="nc">ReLU</span><span class="p">()(</span><span class="n">features</span><span class="p">[</span><span class="mi">4</span><span class="p">])</span>
        <span class="n">upconv5</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">upconv5</span><span class="p">(</span><span class="n">dense_features</span><span class="p">)</span> <span class="c1"># H/16
</span>        <span class="n">upconv5</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">bn5</span><span class="p">(</span><span class="n">upconv5</span><span class="p">)</span>
        <span class="n">concat5</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">upconv5</span><span class="p">,</span> <span class="n">skip3</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">iconv5</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">conv5</span><span class="p">(</span><span class="n">concat5</span><span class="p">)</span>
        
        <span class="n">upconv4</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">upconv4</span><span class="p">(</span><span class="n">iconv5</span><span class="p">)</span> <span class="c1"># H/8
</span>        <span class="n">upconv4</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">bn4</span><span class="p">(</span><span class="n">upconv4</span><span class="p">)</span>
        <span class="n">concat4</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">upconv4</span><span class="p">,</span> <span class="n">skip2</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">iconv4</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">conv4</span><span class="p">(</span><span class="n">concat4</span><span class="p">)</span>
        <span class="n">iconv4</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">bn4_2</span><span class="p">(</span><span class="n">iconv4</span><span class="p">)</span>
        
        <span class="n">daspp_3</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">daspp_3</span><span class="p">(</span><span class="n">iconv4</span><span class="p">)</span>
        <span class="n">concat4_2</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">concat4</span><span class="p">,</span> <span class="n">daspp_3</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">daspp_6</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">daspp_6</span><span class="p">(</span><span class="n">concat4_2</span><span class="p">)</span>
        <span class="n">concat4_3</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">concat4_2</span><span class="p">,</span> <span class="n">daspp_6</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">daspp_12</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">daspp_12</span><span class="p">(</span><span class="n">concat4_3</span><span class="p">)</span>
        <span class="n">concat4_4</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">concat4_3</span><span class="p">,</span> <span class="n">daspp_12</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">daspp_18</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">daspp_18</span><span class="p">(</span><span class="n">concat4_4</span><span class="p">)</span>
        <span class="n">concat4_5</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">concat4_4</span><span class="p">,</span> <span class="n">daspp_18</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">daspp_24</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">daspp_24</span><span class="p">(</span><span class="n">concat4_5</span><span class="p">)</span>
        <span class="n">concat4_daspp</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">iconv4</span><span class="p">,</span> <span class="n">daspp_3</span><span class="p">,</span> <span class="n">daspp_6</span><span class="p">,</span> <span class="n">daspp_12</span><span class="p">,</span> <span class="n">daspp_18</span><span class="p">,</span> <span class="n">daspp_24</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">daspp_feat</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">daspp_conv</span><span class="p">(</span><span class="n">concat4_daspp</span><span class="p">)</span>
        
        <span class="n">reduc8x8</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">reduc8x8</span><span class="p">(</span><span class="n">daspp_feat</span><span class="p">)</span>
        <span class="n">plane_normal_8x8</span> <span class="o">=</span> <span class="n">reduc8x8</span><span class="p">[:,</span> <span class="p">:</span><span class="mi">3</span><span class="p">,</span> <span class="p">:,</span> <span class="p">:]</span>
        <span class="n">plane_normal_8x8</span> <span class="o">=</span> <span class="n">torch_nn_func</span><span class="p">.</span><span class="nf">normalize</span><span class="p">(</span><span class="n">plane_normal_8x8</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
        <span class="n">plane_dist_8x8</span> <span class="o">=</span> <span class="n">reduc8x8</span><span class="p">[:,</span> <span class="mi">3</span><span class="p">,</span> <span class="p">:,</span> <span class="p">:]</span>
        <span class="n">plane_eq_8x8</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">plane_normal_8x8</span><span class="p">,</span> <span class="n">plane_dist_8x8</span><span class="p">.</span><span class="nf">unsqueeze</span><span class="p">(</span><span class="mi">1</span><span class="p">)],</span> <span class="mi">1</span><span class="p">)</span>
        <span class="n">depth_8x8</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">lpg8x8</span><span class="p">(</span><span class="n">plane_eq_8x8</span><span class="p">,</span> <span class="n">focal</span><span class="p">)</span>
        <span class="n">depth_8x8_scaled</span> <span class="o">=</span> <span class="n">depth_8x8</span><span class="p">.</span><span class="nf">unsqueeze</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">self</span><span class="p">.</span><span class="n">max_depth</span>
        <span class="n">depth_8x8_scaled_ds</span> <span class="o">=</span> <span class="n">torch_nn_func</span><span class="p">.</span><span class="nf">interpolate</span><span class="p">(</span><span class="n">depth_8x8_scaled</span><span class="p">,</span> <span class="n">scale_factor</span><span class="o">=</span><span class="mf">0.25</span><span class="p">,</span> <span class="n">mode</span><span class="o">=</span><span class="sh">'</span><span class="s">nearest</span><span class="sh">'</span><span class="p">)</span>
        
        <span class="n">upconv3</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">upconv3</span><span class="p">(</span><span class="n">daspp_feat</span><span class="p">)</span> <span class="c1"># H/4
</span>        <span class="n">upconv3</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">bn3</span><span class="p">(</span><span class="n">upconv3</span><span class="p">)</span>
        <span class="n">concat3</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">upconv3</span><span class="p">,</span> <span class="n">skip1</span><span class="p">,</span> <span class="n">depth_8x8_scaled_ds</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">iconv3</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">conv3</span><span class="p">(</span><span class="n">concat3</span><span class="p">)</span>
        
        <span class="n">reduc4x4</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">reduc4x4</span><span class="p">(</span><span class="n">iconv3</span><span class="p">)</span>
        <span class="n">plane_normal_4x4</span> <span class="o">=</span> <span class="n">reduc4x4</span><span class="p">[:,</span> <span class="p">:</span><span class="mi">3</span><span class="p">,</span> <span class="p">:,</span> <span class="p">:]</span>
        <span class="n">plane_normal_4x4</span> <span class="o">=</span> <span class="n">torch_nn_func</span><span class="p">.</span><span class="nf">normalize</span><span class="p">(</span><span class="n">plane_normal_4x4</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
        <span class="n">plane_dist_4x4</span> <span class="o">=</span> <span class="n">reduc4x4</span><span class="p">[:,</span> <span class="mi">3</span><span class="p">,</span> <span class="p">:,</span> <span class="p">:]</span>
        <span class="n">plane_eq_4x4</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">plane_normal_4x4</span><span class="p">,</span> <span class="n">plane_dist_4x4</span><span class="p">.</span><span class="nf">unsqueeze</span><span class="p">(</span><span class="mi">1</span><span class="p">)],</span> <span class="mi">1</span><span class="p">)</span>
        <span class="n">depth_4x4</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">lpg4x4</span><span class="p">(</span><span class="n">plane_eq_4x4</span><span class="p">,</span> <span class="n">focal</span><span class="p">)</span>
        <span class="n">depth_4x4_scaled</span> <span class="o">=</span> <span class="n">depth_4x4</span><span class="p">.</span><span class="nf">unsqueeze</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">self</span><span class="p">.</span><span class="n">max_depth</span>
        <span class="n">depth_4x4_scaled_ds</span> <span class="o">=</span> <span class="n">torch_nn_func</span><span class="p">.</span><span class="nf">interpolate</span><span class="p">(</span><span class="n">depth_4x4_scaled</span><span class="p">,</span> <span class="n">scale_factor</span><span class="o">=</span><span class="mf">0.5</span><span class="p">,</span> <span class="n">mode</span><span class="o">=</span><span class="sh">'</span><span class="s">nearest</span><span class="sh">'</span><span class="p">)</span>
        
        <span class="n">upconv2</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">upconv2</span><span class="p">(</span><span class="n">iconv3</span><span class="p">)</span> <span class="c1"># H/2
</span>        <span class="n">upconv2</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">bn2</span><span class="p">(</span><span class="n">upconv2</span><span class="p">)</span>
        <span class="n">concat2</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">upconv2</span><span class="p">,</span> <span class="n">skip0</span><span class="p">,</span> <span class="n">depth_4x4_scaled_ds</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">iconv2</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">conv2</span><span class="p">(</span><span class="n">concat2</span><span class="p">)</span>
        
        <span class="n">reduc2x2</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">reduc2x2</span><span class="p">(</span><span class="n">iconv2</span><span class="p">)</span>
        <span class="n">plane_normal_2x2</span> <span class="o">=</span> <span class="n">reduc2x2</span><span class="p">[:,</span> <span class="p">:</span><span class="mi">3</span><span class="p">,</span> <span class="p">:,</span> <span class="p">:]</span>
        <span class="n">plane_normal_2x2</span> <span class="o">=</span> <span class="n">torch_nn_func</span><span class="p">.</span><span class="nf">normalize</span><span class="p">(</span><span class="n">plane_normal_2x2</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">1</span><span class="p">)</span>
        <span class="n">plane_dist_2x2</span> <span class="o">=</span> <span class="n">reduc2x2</span><span class="p">[:,</span> <span class="mi">3</span><span class="p">,</span> <span class="p">:,</span> <span class="p">:]</span>
        <span class="n">plane_eq_2x2</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">plane_normal_2x2</span><span class="p">,</span> <span class="n">plane_dist_2x2</span><span class="p">.</span><span class="nf">unsqueeze</span><span class="p">(</span><span class="mi">1</span><span class="p">)],</span> <span class="mi">1</span><span class="p">)</span>
        <span class="n">depth_2x2</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">lpg2x2</span><span class="p">(</span><span class="n">plane_eq_2x2</span><span class="p">,</span> <span class="n">focal</span><span class="p">)</span>
        <span class="n">depth_2x2_scaled</span> <span class="o">=</span> <span class="n">depth_2x2</span><span class="p">.</span><span class="nf">unsqueeze</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">self</span><span class="p">.</span><span class="n">max_depth</span>
        
        <span class="n">upconv1</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">upconv1</span><span class="p">(</span><span class="n">iconv2</span><span class="p">)</span>
        <span class="n">reduc1x1</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">reduc1x1</span><span class="p">(</span><span class="n">upconv1</span><span class="p">)</span>
        <span class="n">concat1</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cat</span><span class="p">([</span><span class="n">upconv1</span><span class="p">,</span> <span class="n">reduc1x1</span><span class="p">,</span> <span class="n">depth_2x2_scaled</span><span class="p">,</span> <span class="n">depth_4x4_scaled</span><span class="p">,</span> <span class="n">depth_8x8_scaled</span><span class="p">],</span> <span class="n">dim</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>
        <span class="n">iconv1</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">conv1</span><span class="p">(</span><span class="n">concat1</span><span class="p">)</span>
        <span class="n">final_depth</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="n">max_depth</span> <span class="o">*</span> <span class="n">self</span><span class="p">.</span><span class="nf">get_depth</span><span class="p">(</span><span class="n">iconv1</span><span class="p">)</span>

        
        <span class="k">return</span> <span class="n">final_depth</span><span class="p">,</span> <span class="n">depth_8x8_scaled</span><span class="p">,</span> <span class="n">depth_4x4_scaled</span><span class="p">,</span> <span class="n">depth_2x2_scaled</span><span class="p">,</span> <span class="n">reduc1x1</span>

<span class="k">class</span> <span class="nc">encoder</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">(</span><span class="n">encoder</span><span class="p">,</span> <span class="n">self</span><span class="p">).</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="kn">import</span> <span class="n">torchvision.models</span> <span class="k">as</span> <span class="n">models</span>
      
        <span class="n">self</span><span class="p">.</span><span class="n">base_model</span> <span class="o">=</span> <span class="n">models</span><span class="p">.</span><span class="nf">resnet50</span><span class="p">(</span><span class="n">pretrained</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
        <span class="n">self</span><span class="p">.</span><span class="n">feat_names</span> <span class="o">=</span> <span class="p">[</span><span class="sh">'</span><span class="s">relu</span><span class="sh">'</span><span class="p">,</span> <span class="sh">'</span><span class="s">layer1</span><span class="sh">'</span><span class="p">,</span> <span class="sh">'</span><span class="s">layer2</span><span class="sh">'</span><span class="p">,</span> <span class="sh">'</span><span class="s">layer3</span><span class="sh">'</span><span class="p">,</span> <span class="sh">'</span><span class="s">layer4</span><span class="sh">'</span><span class="p">]</span>
        <span class="n">self</span><span class="p">.</span><span class="n">feat_out_channels</span> <span class="o">=</span> <span class="p">[</span><span class="mi">64</span><span class="p">,</span> <span class="mi">256</span><span class="p">,</span> <span class="mi">512</span><span class="p">,</span> <span class="mi">1024</span><span class="p">,</span> <span class="mi">2048</span><span class="p">]</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">):</span>
        <span class="n">feature</span> <span class="o">=</span> <span class="n">x</span>
        <span class="n">skip_feat</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="n">i</span> <span class="o">=</span> <span class="mi">1</span>
        <span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">base_model</span><span class="p">.</span><span class="n">_modules</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
            <span class="k">if</span> <span class="sh">'</span><span class="s">fc</span><span class="sh">'</span> <span class="ow">in</span> <span class="n">k</span> <span class="ow">or</span> <span class="sh">'</span><span class="s">avgpool</span><span class="sh">'</span> <span class="ow">in</span> <span class="n">k</span><span class="p">:</span>
                <span class="k">continue</span>
            <span class="n">feature</span> <span class="o">=</span> <span class="nf">v</span><span class="p">(</span><span class="n">feature</span><span class="p">)</span>
            <span class="k">if</span> <span class="nf">any</span><span class="p">(</span><span class="n">x</span> <span class="ow">in</span> <span class="n">k</span> <span class="k">for</span> <span class="n">x</span> <span class="ow">in</span> <span class="n">self</span><span class="p">.</span><span class="n">feat_names</span><span class="p">):</span>
                <span class="n">skip_feat</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">feature</span><span class="p">)</span>
            <span class="n">i</span> <span class="o">=</span> <span class="n">i</span> <span class="o">+</span> <span class="mi">1</span>
        <span class="k">return</span> <span class="n">skip_feat</span>
    

<span class="k">class</span> <span class="nc">BtsModel</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">(</span><span class="n">BtsModel</span><span class="p">,</span> <span class="n">self</span><span class="p">).</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">encoder</span> <span class="o">=</span> <span class="nf">encoder</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">decoder</span> <span class="o">=</span> <span class="nf">bts</span><span class="p">(</span><span class="n">self</span><span class="p">.</span><span class="n">encoder</span><span class="p">.</span><span class="n">feat_out_channels</span><span class="p">,</span> <span class="mi">512</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">x</span><span class="p">,</span> <span class="n">focal</span><span class="o">=</span><span class="mi">1</span><span class="p">):</span>
        <span class="n">skip_feat</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">encoder</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
        <span class="k">return</span> <span class="n">self</span><span class="p">.</span><span class="nf">decoder</span><span class="p">(</span><span class="n">skip_feat</span><span class="p">,</span> <span class="n">focal</span><span class="p">)</span>
</code></pre></div></div>

<h2 id="depth-shift-and-focal-scale-network">Depth shift and focal scale network</h2>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code>    
<span class="k">class</span> <span class="nc">MEADSTD_TANH_NORM_Loss</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="sh">"""</span><span class="s">
    loss = MAE((d-u)/s - d</span><span class="sh">'</span><span class="s">) + MAE(tanh(0.01*(d-u)/s) - tanh(0.01*d</span><span class="sh">'</span><span class="s">))
    </span><span class="sh">"""</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">valid_threshold</span><span class="o">=-</span><span class="mf">1e-8</span><span class="p">,</span> <span class="n">max_threshold</span><span class="o">=</span><span class="mf">1e8</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">(</span><span class="n">MEADSTD_TANH_NORM_Loss</span><span class="p">,</span> <span class="n">self</span><span class="p">).</span><span class="nf">__init__</span><span class="p">()</span>
        <span class="n">self</span><span class="p">.</span><span class="n">valid_threshold</span> <span class="o">=</span> <span class="n">valid_threshold</span>
        <span class="n">self</span><span class="p">.</span><span class="n">max_threshold</span> <span class="o">=</span> <span class="n">max_threshold</span>
        <span class="c1">#self.thres1 = 0.9
</span> 
    <span class="k">def</span> <span class="nf">transform</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">gt</span><span class="p">):</span>
        <span class="c1"># Get mean and standard deviation
</span>        <span class="n">data_mean</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="n">data_std_dev</span> <span class="o">=</span> <span class="p">[]</span>
        <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">gt</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]):</span>
            <span class="n">gt_i</span> <span class="o">=</span> <span class="n">gt</span><span class="p">[</span><span class="n">i</span><span class="p">]</span>
            <span class="n">mask</span> <span class="o">=</span> <span class="n">gt_i</span> <span class="o">&gt;</span> <span class="mi">0</span>
            <span class="n">depth_valid</span> <span class="o">=</span> <span class="n">gt_i</span><span class="p">[</span><span class="n">mask</span><span class="p">]</span>
            <span class="k">if</span> <span class="n">depth_valid</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span> <span class="o">&lt;</span> <span class="mi">10</span><span class="p">:</span>
                <span class="n">data_mean</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="mi">0</span><span class="p">).</span><span class="nf">cuda</span><span class="p">())</span>
                <span class="n">data_std_dev</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="mi">1</span><span class="p">).</span><span class="nf">cuda</span><span class="p">())</span>
                <span class="k">continue</span>
            <span class="n">size</span> <span class="o">=</span> <span class="n">depth_valid</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
            <span class="n">depth_valid_sort</span><span class="p">,</span> <span class="n">_</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">sort</span><span class="p">(</span><span class="n">depth_valid</span><span class="p">,</span> <span class="mi">0</span><span class="p">)</span>
            <span class="n">depth_valid_mask</span> <span class="o">=</span> <span class="n">depth_valid_sort</span><span class="p">[</span><span class="nf">int</span><span class="p">(</span><span class="n">size</span><span class="o">*</span><span class="mf">0.1</span><span class="p">):</span> <span class="o">-</span><span class="nf">int</span><span class="p">(</span><span class="n">size</span><span class="o">*</span><span class="mf">0.1</span><span class="p">)]</span>
            <span class="n">data_mean</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">depth_valid_mask</span><span class="p">.</span><span class="nf">mean</span><span class="p">())</span>
            <span class="n">data_std_dev</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">depth_valid_mask</span><span class="p">.</span><span class="nf">std</span><span class="p">())</span>
        <span class="n">data_mean</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span><span class="n">data_mean</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">0</span><span class="p">).</span><span class="nf">cuda</span><span class="p">()</span>
        <span class="n">data_std_dev</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">stack</span><span class="p">(</span><span class="n">data_std_dev</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="mi">0</span><span class="p">).</span><span class="nf">cuda</span><span class="p">()</span>

        <span class="k">return</span> <span class="n">data_mean</span><span class="p">,</span> <span class="n">data_std_dev</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">pred</span><span class="p">,</span> <span class="n">gt</span><span class="p">):</span>
        <span class="sh">"""</span><span class="s">
        Calculate loss.
        </span><span class="sh">"""</span>
        <span class="c1">#gt = torch.nn.functional.interpolate(gt,
</span>        <span class="c1">#                                    size=(
</span>        <span class="c1">#                                        pred.size()[2], pred.size()[3]),
</span>        <span class="c1">#                                    mode='nearest').to('cuda')
</span>        <span class="n">mask</span> <span class="o">=</span> <span class="p">(</span><span class="n">gt</span> <span class="o">&gt;</span> <span class="n">self</span><span class="p">.</span><span class="n">valid_threshold</span><span class="p">)</span> <span class="o">&amp;</span> <span class="p">(</span><span class="n">gt</span> <span class="o">&lt;</span> <span class="n">self</span><span class="p">.</span><span class="n">max_threshold</span><span class="p">)</span>   <span class="c1"># [b, c, h, w]
</span>        <span class="n">mask_sum</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">sum</span><span class="p">(</span><span class="n">mask</span><span class="p">,</span> <span class="n">dim</span><span class="o">=</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">))</span>
        <span class="c1"># mask invalid batches
</span>        <span class="n">mask_batch</span> <span class="o">=</span> <span class="n">mask_sum</span> <span class="o">&gt;</span> <span class="mi">100</span>
        <span class="k">if</span> <span class="bp">True</span> <span class="ow">not</span> <span class="ow">in</span> <span class="n">mask_batch</span><span class="p">:</span>
            <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tensor</span><span class="p">(</span><span class="mf">0.0</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">float</span><span class="p">).</span><span class="nf">cuda</span><span class="p">()</span>
        <span class="n">mask_maskbatch</span> <span class="o">=</span> <span class="n">mask</span><span class="p">[</span><span class="n">mask_batch</span><span class="p">]</span>
        <span class="n">pred_maskbatch</span> <span class="o">=</span> <span class="n">pred</span><span class="p">[</span><span class="n">mask_batch</span><span class="p">]</span>
        <span class="n">gt_maskbatch</span> <span class="o">=</span> <span class="n">gt</span><span class="p">[</span><span class="n">mask_batch</span><span class="p">]</span>

        <span class="n">gt_mean</span><span class="p">,</span> <span class="n">gt_std</span> <span class="o">=</span> <span class="n">self</span><span class="p">.</span><span class="nf">transform</span><span class="p">(</span><span class="n">gt_maskbatch</span><span class="p">)</span>
        <span class="n">gt_trans</span> <span class="o">=</span> <span class="p">(</span><span class="n">gt_maskbatch</span> <span class="o">-</span> <span class="n">gt_mean</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">])</span> <span class="o">/</span> <span class="p">(</span><span class="n">gt_std</span><span class="p">[:,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">,</span> <span class="bp">None</span><span class="p">]</span> <span class="o">+</span> <span class="mf">1e-8</span><span class="p">)</span>

        <span class="n">B</span><span class="p">,</span> <span class="n">C</span><span class="p">,</span> <span class="n">H</span><span class="p">,</span> <span class="n">W</span> <span class="o">=</span> <span class="n">gt_maskbatch</span><span class="p">.</span><span class="n">shape</span>
        <span class="n">loss</span> <span class="o">=</span> <span class="mi">0</span>
        <span class="n">loss_tanh</span> <span class="o">=</span> <span class="mi">0</span>
        <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">B</span><span class="p">):</span>
            <span class="n">mask_i</span> <span class="o">=</span> <span class="n">mask_maskbatch</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="p">...]</span>
            <span class="n">pred_depth_i</span> <span class="o">=</span> <span class="n">pred_maskbatch</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="p">...][</span><span class="n">mask_i</span><span class="p">]</span>
            <span class="n">gt_trans_i</span> <span class="o">=</span> <span class="n">gt_trans</span><span class="p">[</span><span class="n">i</span><span class="p">,</span> <span class="p">...][</span><span class="n">mask_i</span><span class="p">]</span>

            <span class="n">depth_diff</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">abs</span><span class="p">(</span><span class="n">gt_trans_i</span> <span class="o">-</span> <span class="n">pred_depth_i</span><span class="p">)</span>
            <span class="n">loss</span> <span class="o">+=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span><span class="n">depth_diff</span><span class="p">)</span>

            <span class="n">tanh_norm_gt</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tanh</span><span class="p">(</span><span class="mf">0.01</span><span class="o">*</span><span class="n">gt_trans_i</span><span class="p">)</span>
            <span class="n">tanh_norm_pred</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">tanh</span><span class="p">(</span><span class="mf">0.01</span><span class="o">*</span><span class="n">pred_depth_i</span><span class="p">)</span>
            <span class="n">loss_tanh</span> <span class="o">+=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">abs</span><span class="p">(</span><span class="n">tanh_norm_gt</span> <span class="o">-</span> <span class="n">tanh_norm_pred</span><span class="p">))</span>
        <span class="n">loss_out</span> <span class="o">=</span> <span class="n">loss</span><span class="o">/</span><span class="n">B</span> <span class="o">+</span> <span class="n">loss_tanh</span><span class="o">/</span><span class="n">B</span>
        <span class="k">return</span> <span class="n">loss_out</span><span class="p">.</span><span class="nf">float</span><span class="p">()</span>

<span class="k">class</span> <span class="nc">Shift_Loss</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">(</span><span class="n">Shift_Loss</span><span class="p">,</span> <span class="n">self</span><span class="p">).</span><span class="nf">__init__</span><span class="p">()</span>
    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">pred</span><span class="p">,</span> <span class="n">gt</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">torch</span><span class="p">.</span><span class="nf">abs</span><span class="p">(</span><span class="n">pred</span> <span class="o">-</span> <span class="n">gt</span><span class="p">)</span>


<span class="k">class</span> <span class="nc">MAE_error</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">(</span><span class="n">MAE_error</span><span class="p">,</span> <span class="n">self</span><span class="p">).</span><span class="nf">__init__</span><span class="p">()</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">prediction</span><span class="p">,</span> <span class="n">gt</span><span class="p">):</span>
        <span class="c1"># prediction = prediction[:, 0:1]
</span>        <span class="n">abs_err</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">abs</span><span class="p">(</span><span class="n">prediction</span> <span class="o">-</span> <span class="n">gt</span><span class="p">)</span>
        <span class="n">mask</span> <span class="o">=</span> <span class="p">(</span><span class="n">gt</span> <span class="o">&gt;</span> <span class="mf">1e-3</span><span class="p">).</span><span class="nf">detach</span><span class="p">()</span>
        <span class="n">mae_error</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span><span class="n">abs_err</span><span class="p">[</span><span class="n">mask</span><span class="p">])</span>
        <span class="k">return</span> <span class="n">mae_error</span>

<span class="k">class</span> <span class="nc">RelMAE_error</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">(</span><span class="n">RelMAE_error</span><span class="p">,</span> <span class="n">self</span><span class="p">).</span><span class="nf">__init__</span><span class="p">()</span>
    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">prediction</span><span class="p">,</span> <span class="n">gt</span><span class="p">):</span>
        <span class="c1"># prediction = prediction[:, 0:1]
</span>        <span class="c1">#prediction = torch.clamp(prediction, min=1e-4)
</span>        <span class="n">prediction</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">abs</span><span class="p">(</span><span class="n">prediction</span><span class="p">)</span>
        <span class="n">abs_err</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">abs</span><span class="p">(</span><span class="n">prediction</span> <span class="o">-</span> <span class="n">gt</span><span class="p">)</span>
        <span class="n">mask</span> <span class="o">=</span> <span class="p">(</span><span class="n">gt</span> <span class="o">&gt;</span> <span class="mf">1e-3</span><span class="p">).</span><span class="nf">detach</span><span class="p">()</span>
        <span class="n">mae_error</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span><span class="n">abs_err</span><span class="p">[</span><span class="n">mask</span><span class="p">]</span><span class="o">/</span><span class="n">gt</span><span class="p">[</span><span class="n">mask</span><span class="p">])</span>
        <span class="k">return</span> <span class="n">mae_error</span>
<span class="k">class</span> <span class="nc">Gamma_Metric</span><span class="p">(</span><span class="n">nn</span><span class="p">.</span><span class="n">Module</span><span class="p">):</span>
    <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="n">self</span><span class="p">):</span>
        <span class="nf">super</span><span class="p">(</span><span class="n">Gamma_Metric</span><span class="p">,</span> <span class="n">self</span><span class="p">).</span><span class="nf">__init__</span><span class="p">()</span>

    <span class="k">def</span> <span class="nf">forward</span><span class="p">(</span><span class="n">self</span><span class="p">,</span> <span class="n">prediction</span><span class="p">,</span> <span class="n">gt</span><span class="p">):</span>
        <span class="c1"># prediction = prediction[:, 0:1]
</span>        <span class="n">mask</span> <span class="o">=</span> <span class="p">(</span><span class="n">gt</span> <span class="o">&gt;</span> <span class="mf">1e-3</span><span class="p">).</span><span class="nf">detach</span><span class="p">()</span>
        <span class="n">prediction</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">abs</span><span class="p">(</span><span class="n">prediction</span><span class="p">)</span> <span class="c1">#torch.clamp(prediction, min=1e-4)
</span>        <span class="n">max_proportion</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">max</span><span class="p">(</span><span class="n">prediction</span><span class="p">[</span><span class="n">mask</span><span class="p">]</span><span class="o">/</span><span class="n">gt</span><span class="p">[</span><span class="n">mask</span><span class="p">],</span> <span class="n">gt</span><span class="p">[</span><span class="n">mask</span><span class="p">]</span><span class="o">/</span><span class="n">prediction</span><span class="p">[</span><span class="n">mask</span><span class="p">])</span>
        <span class="n">gamma</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">mean</span><span class="p">(</span><span class="mf">1.</span><span class="o">*</span><span class="p">(</span><span class="n">max_proportion</span> <span class="o">&lt;</span> <span class="mf">1.25</span><span class="p">))</span>
        <span class="k">return</span> <span class="n">gamma</span>
</code></pre></div></div>

<h2 id="quantitative-results">Quantitative Results</h2>

<p>We plot the evolution of the training and test loss for both models on both dataset. Both models converge on both dataset except for the model adapt on blended MVS were the test loss is fluctuating along a single value which does not show any decreasing trend and that could be a sign of the inability of the model on that dataset. This could be due to the fact that the model is to small to generalize on that data.</p>

<p>The table below resume the evaluation metrics on both dataset and we have the adapt model with the local planar shows slight increase in both metrics accuracy under threshold and relative MAE, for both datasets, comparing to the adapt modal alone. For the accuracy under threshold the highest the better and for relative MAE the lower the better.</p>

<table>
  <thead>
    <tr>
      <th> </th>
      <th>Accuracy under threshold</th>
      <th>Relative MAE</th>
      <th>RMSE</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>NUY Depth  (Adaptive)</td>
      <td>0.530</td>
      <td>4.633</td>
      <td>1.353</td>
    </tr>
    <tr>
      <td>NUY Depth  (Adaptive with local planar)</td>
      <td>0.013</td>
      <td>1.454</td>
      <td>17.2</td>
    </tr>
  </tbody>
</table>

<h2 id="qualitative-results">Qualitative Results</h2>

<p>The pipeline for inference starts by predicting the depth map, on which we apply a sigmoid function to have positive values. The depth map prediction model outputs depth maps with negative values. we Have test using sigmoid, ReLU or Softplus activation function to output the final depth map during training but it led to bad results. Then, we estimate the focal length and the depth shift. To do so, we create a 3D point cloud from a standard focal length and camera optical center. Then we predict refine the focal length by estimating a focal scale from the constructed 3D point. We use the new focal length to construct new 3D point cloud and to refine then the depth by estimating a depth shift. Again use the refined depth to refine another time the focal length. Then we have the final depth and the focal length that we use to generate the final 3D point cloud.</p>

<figure class="figure figure-wide">
<img src="/assets/img/NUY_depth_data_prediction.jpg" alt="Ground truth versus prediction for three scenes. Rows alternate between ground truth and our prediction: input image, depth map, and point cloud from the front, left and top." loading="lazy" decoding="async" data-zoomable="" />
<figcaption>Ground truth versus prediction for three scenes. Rows alternate between ground truth and our prediction: input image, depth map, and point cloud from the front, left and top.</figcaption>
</figure>

<p>Qualitativly, we can see that the approach can capture the global shapes, but the point cloud are very distorded. For example if we compare the left views and top views between group truth and the prediction, we can see easily the huge difference which could be due to the depth prediction.</p>]]></content><author><name>Rida Lefdali</name></author><category term="Technical-post," /><category term="ML" /><summary type="html"><![CDATA[Monocular 3D Mapping]]></summary></entry><entry><title type="html">LLM From Scratch</title><link href="https://lefdrida.github.io/posts/2025/LLM_from_scratch/" rel="alternate" type="text/html" title="LLM From Scratch" /><published>2025-01-20T15:12:00+00:00</published><updated>2025-01-20T15:12:00+00:00</updated><id>https://lefdrida.github.io/posts/2025/LLM_from_scratch</id><content type="html" xml:base="https://lefdrida.github.io/posts/2025/LLM_from_scratch/"><![CDATA[<p>Hi, in this blog, I will try to give an overview about LLMs stacks that can help you to land on any project requiring LLMs.
I will go from core component of each LLM architecture, passing by how inference is done in LLMs. Then I will talk about finetuning LLMs on your own dataset or for your own tasks.<br />
This post will be updated on a regular basis until it covers all possible aspect of LLMs</p>

<h1 id="llm-architecture">LLM architecture</h1>
<p>Most of modern Large language models (LLMs) are based on decoder-only architecture. As illustrated in the figure below, every architecture use the same logic and workflow. They start with a tokenization step followed by an embedding layer, to produce a representation for each word in the input text. Then, they use a variant of Multi-Head Attention block (such as Masked Grouped Query attention in figure example, Multi-Head Latent Attention in models like DeepSeek V3/R1), Feed Forward block (containing Linear layers with activation function such as SiLU) and a Normalization Layer (e.g Layer Normalization, RMS Norm) to produce a general representation of the input text. This representation is finally passed through a linear layer to output a probability distribution over all the tokens in the vocabulary set of the LLM. This probability is used then to generate the next token. The generated token is added to the initial input text and the resulting in text is feeded to the LLM to generate the second next token until we have the full answer. This process makes LLMs autoregressive models which means to generate a token we need to process all the previous tokens.</p>

<figure class="figure figure-wide diagram">
<div class="d-scroll"><svg class="d-svg" viewBox="0 0 960 640" role="img" aria-label="Decoder-only architectures of Qwen3 4B and Llama 3.2 1B, with the SwiGLU feed-forward layer shown in detail"><defs><marker id="llm-arr" viewBox="0 0 10 10" refX="9.5" refY="5" markerWidth="8" markerHeight="8" markerUnits="userSpaceOnUse" orient="auto"><path d="M0,1 L10,5 L0,9 z" class="d-head" /></marker></defs>
<text x="240" y="34" text-anchor="middle" class="d-title acc-a">Qwen3 4B</text>
<text x="240" y="70" text-anchor="middle" class="d-s">Output probabilities over the vocabulary</text>
<rect x="150" y="96" width="180" height="28" rx="6" class="b-out" />
<text x="240" y="114.5" text-anchor="middle" class="d-t">Linear output layer</text>
<path d="M240,96 L240,78" class="d-line" marker-end="url(#llm-arr)" />
<rect x="150" y="146" width="180" height="26" rx="6" class="b-norm" />
<text x="240" y="163.5" text-anchor="middle" class="d-t">RMSNorm</text>
<path d="M240,146 L240,124" class="d-line" marker-end="url(#llm-arr)" />
<rect x="122" y="188" width="236" height="292" rx="10" class="d-group acc-a" />
<text x="352" y="206" text-anchor="end" class="d-s">× 36 layers</text>
<path d="M240,206 L240,172" class="d-line" marker-end="url(#llm-arr)" />
<circle cx="240" cy="214" r="8" class="d-op" />
<path d="M235.6,214 L244.4,214 M240,209.6 L240,218.4" class="d-line" />
<rect x="150" y="234" width="180" height="30" rx="6" class="b-ffn" />
<text x="240" y="253.5" text-anchor="middle" class="d-t">Feed-forward</text>
<path d="M240,234 L240,222" class="d-line" marker-end="url(#llm-arr)" />
<rect x="150" y="278" width="180" height="26" rx="6" class="b-norm" />
<text x="240" y="295.5" text-anchor="middle" class="d-t">RMSNorm</text>
<path d="M240,278 L240,264" class="d-line" marker-end="url(#llm-arr)" />
<path d="M240,322 L240,304" class="d-line" marker-end="url(#llm-arr)" />
<circle cx="240" cy="313" r="2.6" class="d-dot" />
<path d="M240,313 L344,313 L344,214 L248,214" class="d-line" marker-end="url(#llm-arr)" />
<circle cx="240" cy="330" r="8" class="d-op" />
<path d="M235.6,330 L244.4,330 M240,325.6 L240,334.4" class="d-line" />
<rect x="150" y="346" width="180" height="64" rx="6" class="b-attn" />
<text x="240" y="374.5" text-anchor="middle" class="d-t">Masked grouped-query</text>
<text x="240" y="390.5" text-anchor="middle" class="d-t">attention</text>
<path d="M240,346 L240,338" class="d-line" marker-end="url(#llm-arr)" />
<rect x="150" y="428" width="180" height="26" rx="6" class="b-norm" />
<text x="240" y="445.5" text-anchor="middle" class="d-t">RMSNorm</text>
<path d="M240,428 L240,410" class="d-line" marker-end="url(#llm-arr)" />
<rect x="150" y="506" width="180" height="28" rx="6" class="b-embed" />
<text x="240" y="524.5" text-anchor="middle" class="d-t">Embedding layer</text>
<path d="M240,506 L240,454" class="d-line" marker-end="url(#llm-arr)" />
<circle cx="240" cy="468" r="2.6" class="d-dot" />
<path d="M240,468 L344,468 L344,330 L248,330" class="d-line" marker-end="url(#llm-arr)" />
<rect x="150" y="562" width="180" height="28" rx="6" class="b-plain" />
<text x="240" y="580.5" text-anchor="middle" class="d-t">Tokenized text</text>
<path d="M240,562 L240,534" class="d-line" marker-end="url(#llm-arr)" />
<text x="240" y="630" text-anchor="middle" class="d-s">Input text</text>
<path d="M240,614 L240,590" class="d-line" marker-end="url(#llm-arr)" />
<rect x="16" y="352" width="96" height="24" rx="6" class="b-pos" />
<text x="64" y="368.5" text-anchor="middle" class="d-t d-sm">RoPE</text>
<path d="M112,364 L150,364" class="d-line" marker-end="url(#llm-arr)" />
<rect x="16" y="384" width="96" height="24" rx="6" class="b-norm d-new" />
<text x="64" y="400.5" text-anchor="middle" class="d-t d-sm">Q/K RMSNorm</text>
<path d="M112,396 L150,396" class="d-line" marker-end="url(#llm-arr)" />
<text x="600" y="34" text-anchor="middle" class="d-title acc-b">Llama 3.2 1B</text>
<text x="600" y="70" text-anchor="middle" class="d-s">Output probabilities over the vocabulary</text>
<rect x="510" y="96" width="180" height="28" rx="6" class="b-out" />
<text x="600" y="114.5" text-anchor="middle" class="d-t">Linear output layer</text>
<path d="M600,96 L600,78" class="d-line" marker-end="url(#llm-arr)" />
<rect x="510" y="146" width="180" height="26" rx="6" class="b-norm" />
<text x="600" y="163.5" text-anchor="middle" class="d-t">RMSNorm</text>
<path d="M600,146 L600,124" class="d-line" marker-end="url(#llm-arr)" />
<rect x="482" y="188" width="236" height="292" rx="10" class="d-group acc-b" />
<text x="712" y="206" text-anchor="end" class="d-s">× 16 layers</text>
<path d="M600,206 L600,172" class="d-line" marker-end="url(#llm-arr)" />
<circle cx="600" cy="214" r="8" class="d-op" />
<path d="M595.6,214 L604.4,214 M600,209.6 L600,218.4" class="d-line" />
<rect x="510" y="234" width="180" height="30" rx="6" class="b-ffn" />
<text x="600" y="253.5" text-anchor="middle" class="d-t">Feed-forward</text>
<path d="M600,234 L600,222" class="d-line" marker-end="url(#llm-arr)" />
<rect x="510" y="278" width="180" height="26" rx="6" class="b-norm" />
<text x="600" y="295.5" text-anchor="middle" class="d-t">RMSNorm</text>
<path d="M600,278 L600,264" class="d-line" marker-end="url(#llm-arr)" />
<path d="M600,322 L600,304" class="d-line" marker-end="url(#llm-arr)" />
<circle cx="600" cy="313" r="2.6" class="d-dot" />
<path d="M600,313 L704,313 L704,214 L608,214" class="d-line" marker-end="url(#llm-arr)" />
<circle cx="600" cy="330" r="8" class="d-op" />
<path d="M595.6,330 L604.4,330 M600,325.6 L600,334.4" class="d-line" />
<rect x="510" y="346" width="180" height="64" rx="6" class="b-attn" />
<text x="600" y="374.5" text-anchor="middle" class="d-t">Masked grouped-query</text>
<text x="600" y="390.5" text-anchor="middle" class="d-t">attention</text>
<path d="M600,346 L600,338" class="d-line" marker-end="url(#llm-arr)" />
<rect x="510" y="428" width="180" height="26" rx="6" class="b-norm" />
<text x="600" y="445.5" text-anchor="middle" class="d-t">RMSNorm</text>
<path d="M600,428 L600,410" class="d-line" marker-end="url(#llm-arr)" />
<rect x="510" y="506" width="180" height="28" rx="6" class="b-embed" />
<text x="600" y="524.5" text-anchor="middle" class="d-t">Embedding layer</text>
<path d="M600,506 L600,454" class="d-line" marker-end="url(#llm-arr)" />
<circle cx="600" cy="468" r="2.6" class="d-dot" />
<path d="M600,468 L704,468 L704,330 L608,330" class="d-line" marker-end="url(#llm-arr)" />
<rect x="510" y="562" width="180" height="28" rx="6" class="b-plain" />
<text x="600" y="580.5" text-anchor="middle" class="d-t">Tokenized text</text>
<path d="M600,562 L600,534" class="d-line" marker-end="url(#llm-arr)" />
<text x="600" y="630" text-anchor="middle" class="d-s">Input text</text>
<path d="M600,614 L600,590" class="d-line" marker-end="url(#llm-arr)" />
<rect x="376" y="352" width="96" height="24" rx="6" class="b-pos" />
<text x="424" y="368.5" text-anchor="middle" class="d-t d-sm">RoPE</text>
<path d="M472,364 L510,364" class="d-line" marker-end="url(#llm-arr)" />
<path d="M690,249 L772,300" class="d-leader" />
<rect x="772" y="206" width="176" height="232" rx="10" class="d-inset" />
<path d="M860,250 L860,222" class="d-line" marker-end="url(#llm-arr)" />
<rect x="830" y="250" width="60" height="24" rx="6" class="b-out" />
<text x="860" y="266.5" text-anchor="middle" class="d-t d-sm">Linear</text>
<circle cx="860" cy="298" r="8" class="d-op" />
<path d="M856.7,294.7 L863.3,301.3 M856.7,301.3 L863.3,294.7" class="d-line" />
<path d="M860,290 L860,274" class="d-line" marker-end="url(#llm-arr)" />
<rect x="782" y="314" width="60" height="24" rx="6" class="b-ffn" />
<text x="812" y="330.5" text-anchor="middle" class="d-t d-sm">SiLU</text>
<path d="M812,314 L812,298 L852,298" class="d-line" marker-end="url(#llm-arr)" />
<rect x="782" y="352" width="60" height="24" rx="6" class="b-out" />
<text x="812" y="368.5" text-anchor="middle" class="d-t d-sm">Linear</text>
<path d="M812,352 L812,338" class="d-line" marker-end="url(#llm-arr)" />
<rect x="878" y="352" width="60" height="24" rx="6" class="b-out" />
<text x="908" y="368.5" text-anchor="middle" class="d-t d-sm">Linear</text>
<path d="M908,352 L908,298 L868,298" class="d-line" marker-end="url(#llm-arr)" />
<path d="M812,392 L908,392" class="d-line" />
<path d="M860,404 L860,392" class="d-line" />
<path d="M812,392 L812,376" class="d-line" marker-end="url(#llm-arr)" />
<path d="M908,392 L908,376" class="d-line" marker-end="url(#llm-arr)" />
<text x="860" y="426" text-anchor="middle" class="d-s d-strong">SwiGLU feed-forward</text>
</svg>
</div>
<figcaption>Two modern decoder-only LLMs, Qwen3 4B and Llama 3.2 1B, side by side. Both repeat the same block: RMSNorm, masked grouped-query attention with rotary position embeddings (RoPE), RMSNorm, then a SwiGLU feed-forward layer (detail on the right), each wrapped in a residual connection (⊕). The visible difference is that Qwen3 also normalizes queries and keys (dashed).</figcaption>
</figure>

<p>To have an idea about each component of an LLM, we will explain the original transformers architecture, which is an encoder-decoder architecture. As all models are based on that architecture and only slight changes made to it.</p>

<h2 id="transformers">Transformers</h2>

<p>Released by google in their paper “Attention is all you need” in 2017, transformers are backbone of modern LLMs architectures. They overcome Recurrent Neural Networks limitations. Prior to transformers, RNNs were the standards for sequential data such as text (e.g $s=(w_1, w_2, …, w_n)$ ). An RNN generates a hidden state $h_t$ for each element $w_t$ in the sequence by utilizing the element’s representation and the preceeding hidden state $h_{t-1}$. While this allows the model to capture context, it introduces a critical dependency: the computation for step $t$ must wait for step $t-1$. This sequential dependency causes significat issues:</p>
<ul>
  <li>Inefficiency: Training cannot be parallelized across GPUs</li>
  <li>Instability: RNNs suffer from vanishing/exploding gradients.</li>
  <li>Information Loss: The context vector degrades over long sequences, failing to capture long-range dependencies.</li>
</ul>

<p>Transformers solve these limitation by using a Multi-head attention mechanism to process input tokens in parallel, preserving relationships regardless of distance as illustrated in the figure below.</p>

<figure class="figure figure-2 diagram">
<div class="d-scroll"><svg class="d-svg" viewBox="0 0 640 744" role="img" aria-label="The encoder-decoder transformer architecture"><defs><marker id="tf-arr" viewBox="0 0 10 10" refX="9.5" refY="5" markerWidth="8" markerHeight="8" markerUnits="userSpaceOnUse" orient="auto"><path d="M0,1 L10,5 L0,9 z" class="d-head" /></marker></defs>
<rect x="90" y="386" width="200" height="230" rx="10" class="d-group" />
<text x="82" y="506" text-anchor="end" class="d-s d-strong">N×</text>
<rect x="110" y="400" width="160" height="26" rx="6" class="b-norm" />
<text x="190" y="417.5" text-anchor="middle" class="d-t">Add &amp; norm</text>
<rect x="110" y="440" width="160" height="28" rx="6" class="b-ffn" />
<text x="190" y="458.5" text-anchor="middle" class="d-t">Feed-forward</text>
<path d="M190,440 L190,426" class="d-line" marker-end="url(#tf-arr)" />
<rect x="110" y="496" width="160" height="26" rx="6" class="b-norm" />
<text x="190" y="513.5" text-anchor="middle" class="d-t">Add &amp; norm</text>
<path d="M190,496 L190,468" class="d-line" marker-end="url(#tf-arr)" />
<circle cx="190" cy="482" r="2.6" class="d-dot" />
<path d="M190,482 L98,482 L98,413 L110,413" class="d-line" marker-end="url(#tf-arr)" />
<rect x="110" y="540" width="160" height="40" rx="6" class="b-attn" />
<text x="190" y="556.5" text-anchor="middle" class="d-t">Multi-head</text>
<text x="190" y="572.5" text-anchor="middle" class="d-t">attention</text>
<path d="M190,540 L190,522" class="d-line" marker-end="url(#tf-arr)" />
<circle cx="190" cy="606" r="2.6" class="d-dot" />
<path d="M190,606 L98,606 L98,509 L110,509" class="d-line" marker-end="url(#tf-arr)" />
<circle cx="190" cy="596" r="2.6" class="d-dot" />
<path d="M190,596 L150,596 L150,580" class="d-line" marker-end="url(#tf-arr)" />
<path d="M190,596 L230,596 L230,580" class="d-line" marker-end="url(#tf-arr)" />
<circle cx="190" cy="648" r="9" class="d-op" />
<path d="M185.05,648 L194.95,648 M190,643.05 L190,652.95" class="d-line" />
<path d="M190,639 L190,580" class="d-line" marker-end="url(#tf-arr)" />
<rect x="110" y="672" width="160" height="28" rx="6" class="b-embed" />
<text x="190" y="690.5" text-anchor="middle" class="d-t">Input embedding</text>
<path d="M190,672 L190,657" class="d-line" marker-end="url(#tf-arr)" />
<path d="M190,716 L190,700" class="d-line" marker-end="url(#tf-arr)" />
<text x="190" y="734" text-anchor="middle" class="d-s">Inputs</text>
<path d="M181,648 L156,648" class="d-line" />
<circle cx="142" cy="648" r="14" class="b-pos" />
<path d="M132,648.00 L133,646.15 L134,644.47 L135,643.15 L136,642.29 L137,642.00 L138,642.29 L139,643.15 L140,644.47 L141,646.15 L142,648.00 L143,649.85 L144,651.53 L145,652.85 L146,653.71 L147,654.00 L148,653.71 L149,652.85 L150,651.53 L151,649.85 L152,648.00" class="d-line" />
<text x="120" y="644" text-anchor="end" class="d-s">Positional</text>
<text x="120" y="659" text-anchor="end" class="d-s">encoding</text>
<rect x="350" y="146" width="200" height="470" rx="10" class="d-group" />
<text x="558" y="380" text-anchor="start" class="d-s d-strong">×N</text>
<text x="450" y="30" text-anchor="middle" class="d-s">Output probabilities</text>
<rect x="370" y="50" width="160" height="28" rx="6" class="b-out" />
<text x="450" y="68.5" text-anchor="middle" class="d-t">Softmax</text>
<path d="M450,50 L450,38" class="d-line" marker-end="url(#tf-arr)" />
<rect x="370" y="98" width="160" height="28" rx="6" class="b-out" />
<text x="450" y="116.5" text-anchor="middle" class="d-t">Linear</text>
<path d="M450,98 L450,78" class="d-line" marker-end="url(#tf-arr)" />
<rect x="370" y="160" width="160" height="26" rx="6" class="b-norm" />
<text x="450" y="177.5" text-anchor="middle" class="d-t">Add &amp; norm</text>
<path d="M450,160 L450,126" class="d-line" marker-end="url(#tf-arr)" />
<rect x="370" y="204" width="160" height="30" rx="6" class="b-ffn" />
<text x="450" y="223.5" text-anchor="middle" class="d-t">Feed-forward</text>
<path d="M450,204 L450,186" class="d-line" marker-end="url(#tf-arr)" />
<circle cx="450" cy="250" r="2.6" class="d-dot" />
<path d="M450,250 L542,250 L542,173 L530,173" class="d-line" marker-end="url(#tf-arr)" />
<rect x="370" y="266" width="160" height="26" rx="6" class="b-norm" />
<text x="450" y="283.5" text-anchor="middle" class="d-t">Add &amp; norm</text>
<path d="M450,266 L450,234" class="d-line" marker-end="url(#tf-arr)" />
<rect x="370" y="330" width="160" height="44" rx="6" class="b-attn" />
<text x="450" y="348.5" text-anchor="middle" class="d-t">Multi-head</text>
<text x="450" y="364.5" text-anchor="middle" class="d-t">attention</text>
<path d="M450,330 L450,292" class="d-line" marker-end="url(#tf-arr)" />
<path d="M450,438 L450,374" class="d-line" marker-end="url(#tf-arr)" />
<circle cx="450" cy="420" r="2.6" class="d-dot" />
<path d="M450,420 L542,420 L542,279 L530,279" class="d-line" marker-end="url(#tf-arr)" />
<rect x="370" y="438" width="160" height="26" rx="6" class="b-norm" />
<text x="450" y="455.5" text-anchor="middle" class="d-t">Add &amp; norm</text>
<rect x="370" y="500" width="160" height="44" rx="6" class="b-attn" />
<text x="450" y="518.5" text-anchor="middle" class="d-t">Masked multi-head</text>
<text x="450" y="534.5" text-anchor="middle" class="d-t">attention</text>
<path d="M450,500 L450,464" class="d-line" marker-end="url(#tf-arr)" />
<circle cx="450" cy="584" r="2.6" class="d-dot" />
<path d="M450,584 L542,584 L542,451 L530,451" class="d-line" marker-end="url(#tf-arr)" />
<circle cx="450" cy="566" r="2.6" class="d-dot" />
<path d="M450,566 L410,566 L410,544" class="d-line" marker-end="url(#tf-arr)" />
<path d="M450,566 L490,566 L490,544" class="d-line" marker-end="url(#tf-arr)" />
<circle cx="450" cy="648" r="9" class="d-op" />
<path d="M445.05,648 L454.95,648 M450,643.05 L450,652.95" class="d-line" />
<path d="M450,639 L450,544" class="d-line" marker-end="url(#tf-arr)" />
<rect x="370" y="672" width="160" height="28" rx="6" class="b-embed" />
<text x="450" y="690.5" text-anchor="middle" class="d-t">Output embedding</text>
<path d="M450,672 L450,657" class="d-line" marker-end="url(#tf-arr)" />
<path d="M450,716 L450,700" class="d-line" marker-end="url(#tf-arr)" />
<text x="450" y="734" text-anchor="middle" class="d-s">Outputs (shifted right)</text>
<path d="M459,648 L484,648" class="d-line" />
<circle cx="498" cy="648" r="14" class="b-pos" />
<path d="M488,648.00 L489,646.15 L490,644.47 L491,643.15 L492,642.29 L493,642.00 L494,642.29 L495,643.15 L496,644.47 L497,646.15 L498,648.00 L499,649.85 L500,651.53 L501,652.85 L502,653.71 L503,654.00 L504,653.71 L505,652.85 L506,651.53 L507,649.85 L508,648.00" class="d-line" />
<text x="520" y="644" text-anchor="start" class="d-s">Positional</text>
<text x="520" y="659" text-anchor="start" class="d-s">encoding</text>
<path d="M190,400 L190,366 L318,366 L318,392 L400,392 L400,374" class="d-line" marker-end="url(#tf-arr)" />
<circle cx="422" cy="392" r="2.6" class="d-dot" />
<path d="M422,392 L422,374" class="d-line" marker-end="url(#tf-arr)" />
</svg>
</div>
<figcaption>The original encoder–decoder transformer (Vaswani et al., 2017). The encoder (left) builds a representation of the input; the decoder (right) generates the output one token at a time, attending to its own previous tokens and, through cross-attention, to the encoder output.</figcaption>
</figure>

<p>Let’s dig into the architecture of a transformer.</p>

<h2 id="input-embedding-and-positional-encodding">Input Embedding and positional Encodding.</h2>

<ol>
  <li><strong>From text to Tokens:</strong> The input to an LLM is a sequence of tokens ids, denoted as $s=(t_1, t_2, …, t_L)$ ($L$ represents the length of the sequence). These tokens ids are generated by a tokenizer (a process we will cover later), which takes the sentence and splits it into words or sub-words called tokens and finally each token is mapped to its own id. Each LLM have its own tokenizer, for example tokenizer of GPT is different from LLama and so on. The figure below ilustrate this process on the sentence “The mind of man is capable of anything.” (taken from heart of darkness by Joseph Conrad)</li>
</ol>

<figure class="figure figure-2 diagram">
<div class="d-scroll"><svg class="d-svg" viewBox="0 0 700 184" role="img" aria-label="A sentence split into tokens, each mapped to an integer id"><defs><marker id="tok-arr" viewBox="0 0 10 10" refX="9.5" refY="5" markerWidth="8" markerHeight="8" markerUnits="userSpaceOnUse" orient="auto"><path d="M0,1 L10,5 L0,9 z" class="d-head" /></marker></defs>
<text x="350" y="34" text-anchor="middle" class="d-sentence">The mind of man is capable of anything.</text>
<path d="M350,50 L350,92" class="d-line" marker-end="url(#tok-arr)" />
<text x="362" y="76" text-anchor="start" class="d-s d-accent">tokenize</text>
<text x="91.2" y="125" text-anchor="end" class="d-s">tokens</text>
<text x="91.2" y="164" text-anchor="end" class="d-s">ids</text>
<rect x="103.2" y="104" width="43.4" height="32" rx="6" class="b-token" />
<text x="124.9" y="124.5" text-anchor="middle" class="d-mono">The</text>
<text x="124.9" y="164" text-anchor="middle" class="d-mono d-muted">791</text>
<rect x="154.6" y="104" width="51.2" height="32" rx="6" class="b-token" />
<text x="180.2" y="124.5" text-anchor="middle" class="d-mono">mind</text>
<text x="180.2" y="164" text-anchor="middle" class="d-mono d-muted">4059</text>
<rect x="213.8" y="104" width="35.6" height="32" rx="6" class="b-token" />
<text x="231.6" y="124.5" text-anchor="middle" class="d-mono">of</text>
<text x="231.6" y="164" text-anchor="middle" class="d-mono d-muted">315</text>
<rect x="257.4" y="104" width="43.4" height="32" rx="6" class="b-token" />
<text x="279.1" y="124.5" text-anchor="middle" class="d-mono">man</text>
<text x="279.1" y="164" text-anchor="middle" class="d-mono d-muted">893</text>
<rect x="308.8" y="104" width="35.6" height="32" rx="6" class="b-token" />
<text x="326.6" y="124.5" text-anchor="middle" class="d-mono">is</text>
<text x="326.6" y="164" text-anchor="middle" class="d-mono d-muted">374</text>
<rect x="352.4" y="104" width="74.6" height="32" rx="6" class="b-token" />
<text x="389.7" y="124.5" text-anchor="middle" class="d-mono">capable</text>
<text x="389.7" y="164" text-anchor="middle" class="d-mono d-muted">13171</text>
<rect x="435.0" y="104" width="35.6" height="32" rx="6" class="b-token" />
<text x="452.8" y="124.5" text-anchor="middle" class="d-mono">of</text>
<text x="452.8" y="164" text-anchor="middle" class="d-mono d-muted">315</text>
<rect x="478.6" y="104" width="82.4" height="32" rx="6" class="b-token" />
<text x="519.8" y="124.5" text-anchor="middle" class="d-mono">anything</text>
<text x="519.8" y="164" text-anchor="middle" class="d-mono d-muted">4205</text>
<rect x="569.0" y="104" width="27.8" height="32" rx="6" class="b-token" />
<text x="582.9" y="124.5" text-anchor="middle" class="d-mono">.</text>
<text x="582.9" y="164" text-anchor="middle" class="d-mono d-muted">13</text>
</svg>
</div>
<figcaption>Tokenization of a sentence from <em>Heart of Darkness</em>. The tokenizer splits the text into tokens, then maps each token to its integer id in the model vocabulary.</figcaption>
</figure>

<ol>
  <li><strong>The embedding Layer:</strong> Once tokenized, the sequence is passed through an embedding layer (it is learnable). This maps discrete tokens’ ids to dense vectors. If we assume the embedding dimension is $d_{model}$ (e.g $d_{model}=512$), this step outputs a tensor of shape $(L, d_{model})$. So, each token id $t_{i}$ is now represented by a dense vector of dimension $d_{model}=512$</li>
</ol>

<figure class="figure figure-2 diagram">
<div class="d-scroll"><svg class="d-svg" viewBox="0 0 700 330" role="img" aria-label="Token ids mapped through the embedding layer to dense vectors"><defs><marker id="emb-arr" viewBox="0 0 10 10" refX="9.5" refY="5" markerWidth="8" markerHeight="8" markerUnits="userSpaceOnUse" orient="auto"><path d="M0,1 L10,5 L0,9 z" class="d-head" /></marker></defs>
<text x="65" y="26" text-anchor="middle" class="d-s">tokens</text>
<text x="200" y="26" text-anchor="middle" class="d-s">ids</text>
<text x="504" y="26" text-anchor="middle" class="d-s">embeddings  (L × d_model)</text>
<rect x="20" y="46" width="90" height="22" rx="5" class="b-token" />
<text x="65" y="61.5" text-anchor="middle" class="d-mono d-sm">The</text>
<text x="200" y="61.5" text-anchor="middle" class="d-mono">791</text>
<rect x="320" y="46" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.42" />
<rect x="349" y="46" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.66" />
<rect x="378" y="46" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.84" />
<rect x="407" y="46" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.15" />
<rect x="436" y="46" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.26" />
<rect x="465" y="46" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.29" />
<rect x="494" y="46" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.48" />
<rect x="523" y="46" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.90" />
<rect x="552" y="46" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.18" />
<rect x="581" y="46" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.58" />
<rect x="632" y="46" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.20" />
<rect x="661" y="46" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.27" />
<text x="618" y="61" text-anchor="middle" class="d-s">…</text>
<rect x="20" y="74" width="90" height="22" rx="5" class="b-token" />
<text x="65" y="89.5" text-anchor="middle" class="d-mono d-sm">mind</text>
<text x="200" y="89.5" text-anchor="middle" class="d-mono">4059</text>
<rect x="320" y="74" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.22" />
<rect x="349" y="74" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.38" />
<rect x="378" y="74" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.21" />
<rect x="407" y="74" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.32" />
<rect x="436" y="74" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.89" />
<rect x="465" y="74" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.34" />
<rect x="494" y="74" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.63" />
<rect x="523" y="74" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.34" />
<rect x="552" y="74" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.16" />
<rect x="581" y="74" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.66" />
<rect x="632" y="74" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.42" />
<rect x="661" y="74" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.71" />
<text x="618" y="89" text-anchor="middle" class="d-s">…</text>
<rect x="20" y="102" width="90" height="22" rx="5" class="b-token" />
<text x="65" y="117.5" text-anchor="middle" class="d-mono d-sm">of</text>
<text x="200" y="117.5" text-anchor="middle" class="d-mono">315</text>
<rect x="320" y="102" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.36" />
<rect x="349" y="102" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.55" />
<rect x="378" y="102" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.25" />
<rect x="407" y="102" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.19" />
<rect x="436" y="102" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.75" />
<rect x="465" y="102" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.46" />
<rect x="494" y="102" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.67" />
<rect x="523" y="102" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.58" />
<rect x="552" y="102" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.13" />
<rect x="581" y="102" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.42" />
<rect x="632" y="102" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.46" />
<rect x="661" y="102" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.62" />
<text x="618" y="117" text-anchor="middle" class="d-s">…</text>
<rect x="20" y="130" width="90" height="22" rx="5" class="b-token" />
<text x="65" y="145.5" text-anchor="middle" class="d-mono d-sm">man</text>
<text x="200" y="145.5" text-anchor="middle" class="d-mono">893</text>
<rect x="320" y="130" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.51" />
<rect x="349" y="130" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.43" />
<rect x="378" y="130" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.21" />
<rect x="407" y="130" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.12" />
<rect x="436" y="130" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.75" />
<rect x="465" y="130" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.63" />
<rect x="494" y="130" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.52" />
<rect x="523" y="130" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.57" />
<rect x="552" y="130" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.13" />
<rect x="581" y="130" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.44" />
<rect x="632" y="130" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.61" />
<rect x="661" y="130" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.47" />
<text x="618" y="145" text-anchor="middle" class="d-s">…</text>
<rect x="20" y="158" width="90" height="22" rx="5" class="b-token" />
<text x="65" y="173.5" text-anchor="middle" class="d-mono d-sm">is</text>
<text x="200" y="173.5" text-anchor="middle" class="d-mono">374</text>
<rect x="320" y="158" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.19" />
<rect x="349" y="158" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.17" />
<rect x="378" y="158" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.39" />
<rect x="407" y="158" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.39" />
<rect x="436" y="158" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.94" />
<rect x="465" y="158" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.32" />
<rect x="494" y="158" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.48" />
<rect x="523" y="158" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.14" />
<rect x="552" y="158" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.23" />
<rect x="581" y="158" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.82" />
<rect x="632" y="158" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.44" />
<rect x="661" y="158" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.65" />
<text x="618" y="173" text-anchor="middle" class="d-s">…</text>
<rect x="20" y="186" width="90" height="22" rx="5" class="b-token" />
<text x="65" y="201.5" text-anchor="middle" class="d-mono d-sm">capable</text>
<text x="200" y="201.5" text-anchor="middle" class="d-mono">13171</text>
<rect x="320" y="186" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.59" />
<rect x="349" y="186" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.40" />
<rect x="378" y="186" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.23" />
<rect x="407" y="186" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.15" />
<rect x="436" y="186" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.71" />
<rect x="465" y="186" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.70" />
<rect x="494" y="186" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.45" />
<rect x="523" y="186" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.60" />
<rect x="552" y="186" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.14" />
<rect x="581" y="186" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.40" />
<rect x="632" y="186" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.65" />
<rect x="661" y="186" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.38" />
<text x="618" y="201" text-anchor="middle" class="d-s">…</text>
<rect x="20" y="214" width="90" height="22" rx="5" class="b-token" />
<text x="65" y="229.5" text-anchor="middle" class="d-mono d-sm">of</text>
<text x="200" y="229.5" text-anchor="middle" class="d-mono">315</text>
<rect x="320" y="214" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.36" />
<rect x="349" y="214" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.55" />
<rect x="378" y="214" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.25" />
<rect x="407" y="214" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.19" />
<rect x="436" y="214" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.75" />
<rect x="465" y="214" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.46" />
<rect x="494" y="214" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.67" />
<rect x="523" y="214" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.58" />
<rect x="552" y="214" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.13" />
<rect x="581" y="214" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.42" />
<rect x="632" y="214" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.46" />
<rect x="661" y="214" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.62" />
<text x="618" y="229" text-anchor="middle" class="d-s">…</text>
<rect x="20" y="242" width="90" height="22" rx="5" class="b-token" />
<text x="65" y="257.5" text-anchor="middle" class="d-mono d-sm">anything</text>
<text x="200" y="257.5" text-anchor="middle" class="d-mono">4205</text>
<rect x="320" y="242" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.49" />
<rect x="349" y="242" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.47" />
<rect x="378" y="242" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.92" />
<rect x="407" y="242" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.25" />
<rect x="436" y="242" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.34" />
<rect x="465" y="242" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.25" />
<rect x="494" y="242" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.31" />
<rect x="523" y="242" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.90" />
<rect x="552" y="242" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.38" />
<rect x="581" y="242" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.59" />
<rect x="632" y="242" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.31" />
<rect x="661" y="242" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.16" />
<text x="618" y="257" text-anchor="middle" class="d-s">…</text>
<rect x="20" y="270" width="90" height="22" rx="5" class="b-token" />
<text x="65" y="285.5" text-anchor="middle" class="d-mono d-sm">.</text>
<text x="200" y="285.5" text-anchor="middle" class="d-mono">13</text>
<rect x="320" y="270" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.93" />
<rect x="349" y="270" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.39" />
<rect x="378" y="270" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.33" />
<rect x="407" y="270" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.24" />
<rect x="436" y="270" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.18" />
<rect x="465" y="270" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.87" />
<rect x="494" y="270" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.55" />
<rect x="523" y="270" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.51" />
<rect x="552" y="270" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.37" />
<rect x="581" y="270" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.12" />
<rect x="632" y="270" width="26" height="22" rx="3" class="c-neg" fill-opacity="0.63" />
<rect x="661" y="270" width="26" height="22" rx="3" class="c-pos" fill-opacity="0.62" />
<text x="618" y="285" text-anchor="middle" class="d-s">…</text>
<path d="M118,169 L166,169" class="d-line" marker-end="url(#emb-arr)" />
<text x="142" y="159" text-anchor="middle" class="d-xs">lookup</text>
<path d="M234,169 L306,169" class="d-line" marker-end="url(#emb-arr)" />
<text x="270" y="147" text-anchor="middle" class="d-xs">embedding</text>
<text x="270" y="159" text-anchor="middle" class="d-xs">layer</text>
<path d="M320,316 L688,316" class="d-leader" />
<text x="504" y="310" text-anchor="middle" class="d-xs">d_model = 512</text>
</svg>
</div>
<figcaption>The embedding layer is a lookup table: each token id selects one learned row, so a sequence of L tokens becomes an L × d_model tensor. Cell colour shows the sign and magnitude of each component (values are illustrative).</figcaption>
</figure>

<p>We can use nn module of pytorch to code the embedding layer as follows.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">embedding_layer</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Embedding</span><span class="p">(</span><span class="n">vocab_size</span><span class="p">,</span> <span class="n">d_model</span><span class="p">)</span>
<span class="n">x_embedding</span> <span class="o">=</span> <span class="nf">embedding</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
</code></pre></div></div>

<ol>
  <li><strong>Positional Encodings:</strong> Here lies a critical challenge. Unlike RNNs, transformers process all tokens in parallel. This means the model has no inherent sense of order (it cannot distinguish between “the dog bit the man” and “The man bit the dog”). To solve this, we add Positional Embedding vector (not learnable) to each token’s embedding vector. This adds information about the token’s absolute or relative position in the sentence and help the model to understand the word function (whether it acts as noun, verb, subject etc). Without this, the Multi-Head Attention would view the sentence as a chaotic “bag of words” rather than a structured sequence.</li>
</ol>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1">#  Create a mtrix of shape (seq_len, d_model)
</span>  <span class="n">pe</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">zeros</span><span class="p">(</span><span class="n">seq_len</span><span class="p">,</span> <span class="n">d_model</span><span class="p">)</span>
  <span class="c1"># Create a vector of shape (seq_len)
</span>  <span class="n">position</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">seq_len</span><span class="p">,</span> <span class="n">dtype</span><span class="o">=</span><span class="n">torch</span><span class="p">.</span><span class="nb">float</span><span class="p">).</span><span class="nf">unsqueeze</span><span class="p">(</span><span class="mi">1</span><span class="p">)</span> <span class="c1"># (seq_len, 1)
</span>  <span class="n">div_term</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">exp</span><span class="p">(</span><span class="n">torch</span><span class="p">.</span><span class="nf">arange</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">d_model</span><span class="p">,</span> <span class="mi">2</span><span class="p">).</span><span class="nf">float</span><span class="p">()</span><span class="o">*</span><span class="p">(</span><span class="o">-</span><span class="n">math</span><span class="p">.</span><span class="nf">log</span><span class="p">(</span><span class="mf">10000.0</span><span class="p">)</span> <span class="o">/</span> <span class="n">d_model</span><span class="p">))</span>

  <span class="c1">## Apply sin
</span>  <span class="n">pe</span><span class="p">[:,</span> <span class="mi">0</span><span class="p">::</span><span class="mi">2</span><span class="p">]</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">sin</span><span class="p">(</span><span class="n">position</span><span class="o">*</span><span class="n">div_term</span><span class="p">)</span>
  <span class="n">pe</span><span class="p">[:,</span> <span class="mi">1</span><span class="p">::</span><span class="mi">2</span><span class="p">]</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">cos</span><span class="p">(</span><span class="n">position</span><span class="o">*</span><span class="n">div_term</span><span class="p">)</span>

  <span class="n">pe</span><span class="p">.</span><span class="nf">unsqueeze_</span><span class="p">(</span><span class="mi">0</span><span class="p">)</span> <span class="c1"># (1, seq_len, d_model)
</span></code></pre></div></div>

<h2 id="multi-headed-attention">Multi-Headed Attention</h2>
<p>As illustrated in the transformer architecture above, the input embedding and positional encoding block produce an input tensor $X$ of size $(L, d_{model})$ which contains a dense vectors representing tokens in the text sequence. This input tensor is feeded then to Multi-Head Attention block to capture token’s interaction with other words. 
Multi-head Attention block is based on Scaled Dot-Product Attention, which we will explain first.</p>

<p><strong>Scaled Dot-Product Attention</strong>
The scaled Dot-Product attention takes as input three matrices of size $(L, d_{model})$: Queries $Q$, Keys $K$ and Values $V$. Those three matrices are just the input tensor (often via linear projection) where:</p>

\[Q = X \qquad K = X \qquad V = X\]

<p>The mechanism then compute a new representation for each token,  enriching it with contextual information from other tokens using The following formula and the figure below illustrate the mechanism:</p>

\[\text{Attention}(Q, K, V) = \text{softmax}(\frac{QK^{T}}{\sqrt{d_k}})V\]

<figure class="figure figure-small diagram">
<div class="d-scroll"><svg class="d-svg" viewBox="0 0 540 384" role="img" aria-label="Scaled dot-product attention"><defs><marker id="sdpa-arr" viewBox="0 0 10 10" refX="9.5" refY="5" markerWidth="8" markerHeight="8" markerUnits="userSpaceOnUse" orient="auto"><path d="M0,1 L10,5 L0,9 z" class="d-head" /></marker></defs>
<path d="M190,40 L190,12" class="d-line" marker-end="url(#sdpa-arr)" />
<rect x="90" y="40" width="200" height="28" rx="6" class="b-attn" />
<text x="190" y="58.5" text-anchor="middle" class="d-t">MatMul</text>
<rect x="90" y="100" width="120" height="28" rx="6" class="b-embed" />
<text x="150" y="118.5" text-anchor="middle" class="d-t">Softmax</text>
<path d="M150,100 L150,68" class="d-line" marker-end="url(#sdpa-arr)" />
<rect x="90" y="160" width="120" height="28" rx="6" class="b-plain d-dashed" />
<text x="150" y="178.5" text-anchor="middle" class="d-t d-sm">Mask (optional)</text>
<path d="M150,160 L150,128" class="d-line" marker-end="url(#sdpa-arr)" />
<rect x="90" y="220" width="120" height="28" rx="6" class="b-norm" />
<text x="150" y="238.5" text-anchor="middle" class="d-t">Scale</text>
<path d="M150,220 L150,188" class="d-line" marker-end="url(#sdpa-arr)" />
<rect x="90" y="280" width="120" height="28" rx="6" class="b-attn" />
<text x="150" y="298.5" text-anchor="middle" class="d-t">MatMul</text>
<path d="M150,280 L150,248" class="d-line" marker-end="url(#sdpa-arr)" />
<text x="120" y="370" text-anchor="middle" class="d-t d-strong">Q</text>
<path d="M120,352 L120,308" class="d-line" marker-end="url(#sdpa-arr)" />
<text x="180" y="370" text-anchor="middle" class="d-t d-strong">K</text>
<path d="M180,352 L180,308" class="d-line" marker-end="url(#sdpa-arr)" />
<text x="260" y="370" text-anchor="middle" class="d-t d-strong">V</text>
<path d="M260,352 L260,68" class="d-line" marker-end="url(#sdpa-arr)" />
<path d="M300,54 L316,54" class="d-leader" />
<text x="324" y="58" text-anchor="start" class="d-s">weighted sum of the values</text>
<path d="M220,114 L316,114" class="d-leader" />
<text x="324" y="118" text-anchor="start" class="d-s">each row becomes a distribution</text>
<path d="M220,174 L316,174" class="d-leader" />
<text x="324" y="178" text-anchor="start" class="d-s">future positions set to −∞</text>
<path d="M220,234 L316,234" class="d-leader" />
<text x="324" y="238" text-anchor="start" class="d-s">divide by √d<tspan class="d-sub" dy="3">k</tspan></text>
<path d="M220,294 L316,294" class="d-leader" />
<text x="324" y="298" text-anchor="start" class="d-s">QKᵀ: an L × L score matrix</text>
</svg>
</div>
<figcaption>Scaled dot-product attention, adapted from Vaswani et al. (2017). Notes on the right describe what each step does to the L × L score matrix.</figcaption>
</figure>

<ol>
  <li>Similarity: $QK^{T}$ calculates the similarity between every Query and every Key</li>
  <li>Scaling: We divide by $\sqrt d_k$ to prevent gradients from vanishing in the softmax.</li>
  <li>Weighting: The softmax turns the scaled similarities into attention scores (or probabilities) representing how relevant every other token is to the current token. Multiplying these scores by the V matrix produces a weighted sum of the value embeddings.</li>
</ol>

<p><em>Properties:</em></p>
<ul>
  <li>Permutation invariant: Attention mechanism is mainly matrix computation. It does not inherently respect the order of the sequence. Changing row order of input  will output the same results. This is why positional embedding is required.</li>
  <li>Masking: The score matrix yielded by the Softmax operation has a size of $L \times L$. If we want to prevent interactions between some tokens (like hiding future tokens during training), we apply a mask - setting those scores to $-\infty$, before applying the softmax function, so their probabilities become zeros.</li>
</ul>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">attention</span><span class="p">(</span><span class="n">query</span><span class="p">,</span> <span class="n">key</span><span class="p">,</span> <span class="n">value</span><span class="p">,</span> <span class="n">mask</span><span class="p">):</span>
  <span class="n">d_k</span> <span class="o">=</span> <span class="n">query</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="o">-</span><span class="mi">1</span><span class="p">]</span>
  <span class="n">attention_scores</span> <span class="o">=</span> <span class="n">query</span><span class="nd">@key.transpose</span><span class="p">(</span><span class="o">-</span><span class="mi">2</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">)</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">d_k</span><span class="p">)</span>
  <span class="k">if</span> <span class="n">mask</span> <span class="ow">is</span> <span class="ow">not</span> <span class="bp">None</span><span class="p">:</span>
      <span class="n">attention_scores</span><span class="p">.</span><span class="nf">masked_fill_</span><span class="p">(</span><span class="n">mask</span><span class="o">==</span><span class="mi">0</span><span class="p">,</span> <span class="o">-</span><span class="mf">1e9</span><span class="p">)</span>
  <span class="n">attention_scores</span> <span class="o">=</span> <span class="n">attention_scores</span><span class="p">.</span><span class="nf">softmax</span><span class="p">(</span><span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
  <span class="n">output</span> <span class="o">=</span> <span class="n">attention_scores</span><span class="nd">@value</span>
  <span class="k">return</span> <span class="n">output</span>
</code></pre></div></div>

<p><strong>Multi-head Attention</strong>
Multi-HEad attention refines the mechanism and improves the model’s performance by allowing it to jointly attend to information from different representation subspaces at different positions.</p>

<p>Instead of performing single attention $d_{model}$-dimensional matrices, it is benificial to linearly project the Q, K, and V matrices $h$ times with different, learned linear projections to $d_k$, $d_k$, $d_v$, respectively.</p>

<p>A scaled dot-product attention is performed on each of the $h$ projected versions of Q, K, and V, yielding  $d_v$-dimensional output values. These are concatenated and once again project to result in the final values. 
The following formula and figure illustrate the process:</p>

\[MultiHead(Q, K, V) = Concat(head_1, ..., head_h)W^{O}\]

\[head_i = Attention(QW_{i}^{Q}, KW_{i}^{K}, VW_{i}^{V})\]

<figure class="figure figure-small diagram">
<div class="d-scroll"><svg class="d-svg" viewBox="0 0 640 430" role="img" aria-label="Multi-head attention: h parallel scaled dot-product attention heads"><defs><marker id="mha-arr" viewBox="0 0 10 10" refX="9.5" refY="5" markerWidth="8" markerHeight="8" markerUnits="userSpaceOnUse" orient="auto"><path d="M0,1 L10,5 L0,9 z" class="d-head" /></marker></defs>
<rect x="210" y="46" width="100" height="28" rx="6" class="b-out" />
<text x="260" y="64.5" text-anchor="middle" class="d-t">Linear</text>
<path d="M260,46 L260,16" class="d-line" marker-end="url(#mha-arr)" />
<rect x="200" y="106" width="120" height="28" rx="6" class="b-norm" />
<text x="260" y="124.5" text-anchor="middle" class="d-t">Concat</text>
<path d="M260,106 L260,74" class="d-line" marker-end="url(#mha-arr)" />
<rect x="146" y="170" width="260" height="48" rx="6" class="b-attn" opacity="0.35" />
<rect x="138" y="178" width="260" height="48" rx="6" class="b-attn" opacity="0.6" />
<rect x="130" y="186" width="260" height="48" rx="6" class="b-attn" />
<text x="260" y="206.5" text-anchor="middle" class="d-t">Scaled dot-product</text>
<text x="260" y="222.5" text-anchor="middle" class="d-t">attention</text>
<path d="M260,186 L260,134" class="d-line" marker-end="url(#mha-arr)" />
<rect x="121" y="284" width="90" height="28" rx="6" class="b-out" opacity="0.35" />
<rect x="113" y="292" width="90" height="28" rx="6" class="b-out" opacity="0.6" />
<rect x="105" y="300" width="90" height="28" rx="6" class="b-out" />
<text x="150" y="318.5" text-anchor="middle" class="d-t">Linear</text>
<path d="M150,300 L150,234" class="d-line" marker-end="url(#mha-arr)" />
<path d="M150,392 L150,328" class="d-line" marker-end="url(#mha-arr)" />
<text x="150" y="412" text-anchor="middle" class="d-t d-strong">V</text>
<rect x="231" y="284" width="90" height="28" rx="6" class="b-out" opacity="0.35" />
<rect x="223" y="292" width="90" height="28" rx="6" class="b-out" opacity="0.6" />
<rect x="215" y="300" width="90" height="28" rx="6" class="b-out" />
<text x="260" y="318.5" text-anchor="middle" class="d-t">Linear</text>
<path d="M260,300 L260,234" class="d-line" marker-end="url(#mha-arr)" />
<path d="M260,392 L260,328" class="d-line" marker-end="url(#mha-arr)" />
<text x="260" y="412" text-anchor="middle" class="d-t d-strong">K</text>
<rect x="341" y="284" width="90" height="28" rx="6" class="b-out" opacity="0.35" />
<rect x="333" y="292" width="90" height="28" rx="6" class="b-out" opacity="0.6" />
<rect x="325" y="300" width="90" height="28" rx="6" class="b-out" />
<text x="370" y="318.5" text-anchor="middle" class="d-t">Linear</text>
<path d="M370,300 L370,234" class="d-line" marker-end="url(#mha-arr)" />
<path d="M370,392 L370,328" class="d-line" marker-end="url(#mha-arr)" />
<text x="370" y="412" text-anchor="middle" class="d-t d-strong">Q</text>
<path d="M414,170 L422,170 L422,218 L414,218" class="d-leader" />
<path d="M316,60 L446,60" class="d-leader" />
<text x="454" y="64" text-anchor="start" class="d-s">output projection W<tspan class="d-sup" dy="-5">O</tspan></text>
<path d="M326,120 L446,120" class="d-leader" />
<text x="454" y="124" text-anchor="start" class="d-s">join the h head outputs</text>
<path d="M428,194 L446,194" class="d-leader" />
<text x="454" y="198" text-anchor="start" class="d-s">h heads in parallel</text>
<path d="M437,314 L446,314" class="d-leader" />
<text x="454" y="318" text-anchor="start" class="d-s">per-head projections</text>
</svg>
</div>
<figcaption>Multi-head attention, adapted from Vaswani et al. (2017): Q, K and V are projected h times, attention runs on every head in parallel, and the results are concatenated and projected back to d_model.</figcaption>
</figure>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">W_q</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d_model</span><span class="p">,</span> <span class="n">d_model</span><span class="p">)</span>
<span class="n">W_k</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d_model</span><span class="p">,</span> <span class="n">d_model</span><span class="p">)</span>
<span class="n">W_v</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d_model</span><span class="p">,</span> <span class="n">d_model</span><span class="p">)</span>
<span class="n">W_o</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d_model</span><span class="p">,</span> <span class="n">d_model</span><span class="p">)</span>

<span class="n">query</span> <span class="o">=</span> <span class="nc">W_q</span><span class="p">(</span><span class="n">q</span><span class="p">)</span>
<span class="n">key</span> <span class="o">=</span> <span class="nc">W_k</span><span class="p">(</span><span class="n">k</span><span class="p">)</span>
<span class="n">value</span> <span class="o">=</span> <span class="nc">W_v</span><span class="p">(</span><span class="n">v</span><span class="p">)</span>

<span class="n">B</span><span class="p">,</span> <span class="n">seq_len</span> <span class="o">=</span> <span class="n">query</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">],</span> <span class="n">query</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">1</span><span class="p">]</span>

<span class="n">query</span> <span class="o">=</span> <span class="n">query</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span><span class="n">B</span><span class="p">,</span> <span class="n">seq_len</span><span class="p">,</span> <span class="n">h</span><span class="p">,</span> <span class="n">d_k</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
<span class="n">key</span> <span class="o">=</span> <span class="n">key</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span><span class="n">B</span><span class="p">,</span> <span class="n">seq_len</span><span class="p">,</span> <span class="n">h</span><span class="p">,</span> <span class="n">d_k</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>
<span class="n">value</span> <span class="o">=</span> <span class="n">value</span><span class="p">.</span><span class="nf">view</span><span class="p">(</span><span class="n">B</span><span class="p">,</span> <span class="n">seq_len</span><span class="p">,</span> <span class="n">h</span><span class="p">,</span> <span class="n">d_k</span><span class="p">).</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">)</span>

<span class="n">x</span> <span class="o">=</span> <span class="nf">attention</span><span class="p">(</span><span class="n">query</span><span class="p">,</span> <span class="n">key</span><span class="p">,</span> <span class="n">value</span><span class="p">,</span> <span class="n">mask</span><span class="p">)</span>
<span class="n">x</span> <span class="o">=</span> <span class="n">x</span><span class="p">.</span><span class="nf">transpose</span><span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">).</span><span class="nf">contiguous</span><span class="p">().</span><span class="nf">view</span><span class="p">(</span><span class="n">B</span><span class="p">,</span> <span class="n">seq_len</span><span class="p">,</span> <span class="n">d_k</span><span class="o">*</span><span class="n">d_h</span><span class="p">)</span>
<span class="n">x</span> <span class="o">=</span> <span class="nc">W_o</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>
</code></pre></div></div>

<h4 id="add--norm-layer-and-residual-connection">Add &amp; Norm Layer and Residual connection</h4>
<p>The output of the multi-head attention block is a tensor $M$ of size $L \times d_{model}$ which is passed to Add &amp; Norm layer. In this layer the input tensor $X$ is added to $M$ via a residual connection. This addition or residual connection prevents from vanishing gradient. Then the output of this addition is normalized.</p>

<p>Either in the original transformer paper the Norm layer is placed after the attention block or the feed forward layer, known as Post-Normalization, many LLMs architecture use the normalization layer before, known as Pre-Normalization. In 2020, Xiong et al, they showed thatPre-Normalization is more benificial by resulting in more well behaved gradients at initialization and works well without careful learning rate warm-up which is critical for Post-Normalization.</p>

<p>In some LLMs such as OLMo 2, they use Post-Normalization with RMSNorm instead of Layer Norm or Batch Norm as it results in smoother gradients and then more stability in the training.</p>

<h4 id="feed-forward-layer">Feed Forward Layer</h4>

<h4 id="decoder">Decoder</h4>
<p>The decoder is similar to the encoder. It takes the outputs as input and pass them through embedding and position encoding block. The tokens’ tensor is passed as Queries, Keys and Values, through a Masked Multi-head Attention. The output of the Masked Multi-head Attention is passed as Queries to another Multi-Head Attention along with the encoder output which is considered as Keys and Values.</p>

<p>The goal of using Masked Multi-Head Attention is to make the model causal (i.e the output at a certain position can only depend on the words on the previous position). The model must not be able to have information about the future. This is achieved by using the masking property of Scaled Dot-Product Attention. The scores that correspond to the current token and its interaction with future tokens are set to $-\infty$ which will yield to 0 when applying softmax.</p>

<h4 id="linear-and-softmax">Linear and softmax</h4>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">proj</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">Linear</span><span class="p">(</span><span class="n">d_model</span><span class="p">,</span> <span class="n">vocab_size</span><span class="p">)</span>
<span class="n">out</span> <span class="o">=</span> <span class="n">torch</span><span class="p">.</span><span class="nf">log_softmax</span><span class="p">(</span><span class="nf">proj</span><span class="p">(</span><span class="n">x</span><span class="p">),</span> <span class="n">dim</span><span class="o">=-</span><span class="mi">1</span><span class="p">)</span>
</code></pre></div></div>

<h2 id="training">Training</h2>
<p>Training an LLM is done through two steps: Pre-training step which consists of training the LLM on a large scale data (billions to trillions of tokens). The result of this step is a base model and it aims only to encode the world knowledge into the models. This means it can generate token in a way to have meaningful generation but not necessarly correct. For example if we ask the base model “when was the first LLM trained” and it answers “1439”, it gives a good output but it does not matter if it is true. This step is very expansive as it requires powerful resources that scale up with model’s number of parameters and the data. <br />
The Second step is Post-training step which consists of training the base-model on high quality data to align its behavior imporve its capabilities and make it more helpful. For post-training, we can use mainly Supervised fine-tuning (SFT) or reinforcement learning (RL). <br />
Pre-training and SFT consists of optimizing the same loss function and reiforcement learning use different loss function. But the training logic is mainly the same. We will details how we train an LLM in general and then we will give some examples of loss function for RL.</p>

<p>The goal of a language model is to predict the probability of the sequence of tokens. Let $(x_1, x_2, …, x_n)$ be our sequence. Its probability is:</p>

\[Pr(x_1, x_2, ..., x_n) = \prod_{i=1}^{n} Pr(x_i|x_0,x_1, ..., x_{i-1})\]

<p>When applying the log the sequence probability becomes:</p>

\[\log Pr(x_1,x_2,...,x_n) = \sum_{i=1}^{n} \log Pr(x_i|x_0, x_1,...,x_{i-1})\]

<p>So, predicting the next token, we mainly want a token having the highest probability as follows:</p>

\[\hat{x_i} = \underset{x_i \in V}{\operatorname{argmax}} \, Pr(x_i|x_0, x_1, ..., x_{i-1})\]

<p>In SFT, the data is composed from input context $x = {x_1, x_2, …, x_n}$ and the desired output $y = {y_1, y_2, …, y_T}$. The SFT is a multiclass-classification problem, the loss function used is negative log-likelihood of producing the correct sequence $y$ given the input $x$. This is often implemented as cross-entropy between the predicted class by the model and the true class in the dataset.<br />
At seqeunce step $t$, let \(y^{*}_{t}\) the ground truth token and let \(\log p_{\theta}(y^{*}_{t}|x_1, ..., x_n, y_1, ..., y_{t-1})\)  denote the log-probability of producting the token $y^{*}_t$ by the model.</p>

<p>Then the model optimizes the following Loss function:</p>

\[L_{SFT}(\theta) = -E_{(x,y)~D} \sum_{t=1}^{T} \log p_{\theta}(y_{t}|x_1, ..., x_n, y_1, ..., y_{t-1})\]

<p>in Practice we use the following formulation:</p>

\[L_{SFT}(\theta) = -\frac{1}{T} \sum_{t=1}^{T} \log p_{\theta}(y^{*}_{t}|x_1, ..., x_n, y_1, ..., y_{t-1})\]

<p>Intuition: The following loss is trying to maximize always the probability of the ground truth token $y^{*}_{t}$ and push it to be 1. The log is applied on the probabilities which have values between $0$ and $1$, so the -log gives values between $+\infty$ and $0$. So minimizing this loss means pushing the -log to be 0 and then the probabilities to be 1.</p>

<h2 id="inference">Inference</h2>

<p>At inference, we have a context  $x=(x_1, x_2, …, x_n)$   and we want to generate a sequence  $\hat y=(y_1, y_2, …, y_T)$ such that the following conditional probability is maximal:</p>

\[P ( \hat y | x )=\prod_{t=1}^{T} P (y_t | x_0,..., x_n, y_0, ..., y_{t-1})\]

<p>So the generation process is as follows: at eacht time step  $t$  we generate a token  $y_t$  using its conditional probability $P (y_t|x_0,…, x_{n}, y_0, …, y_{t-1})$  .
Add the generated token to the context which is use after to generate the next token $y_{t+1}$  . But how do we use the conditional probabilities to generate the next token?</p>

<p><strong>Greedy Search Strategy</strong>: This strategy consists of selecting the token with the highest conditional probability at each time step $t$:</p>

\[\hat y_{t} = \underset{y_t \in V}{\operatorname{argmax}} \, P (y_{t}|x_1, ..., x_n, y_1, ..., y_{t-1})\]

<p>Selecting always at each time step $t$ the token with the highest probability does not entail that the the entire output sequence has the maximum joint probability. Maybe selecting the second probable token at time step $t$ could lead to have token with higher probability at timestep $t+1$ than a token yielded by selecting the first probable token at timestep $t$.</p>

<p>So, while this method is efficient as it sees at each timestep $t$ one token (the most probable token) comparing to other methods that take into account many tokens and keep track of them to generate the sequence (will be explained later). It can miss better tokens as explained above and lead to short-sighted output.</p>

<p><strong>Beam Search</strong>: At each timestep $t$ we select $n$ first probable tokens ($n$ is the number of beam). This process is repeated until we reach the predifined maximum length $T$ or end-of-sequence token appears. 
Then, we will choose the sequence $y$ that have maximum joint probability $P(y|x)$</p>

<p><strong>Top-k sampling strategy</strong>: It leverage the probability distribution generated by the language model to select a token randomly from the k most likely options. This method add an element of randomness in the generation process.</p>

<p>You might have heared that temperature controls the creativeness of the LLM. Higher temperature more creative model and lower temperature more deterministice model. Actually, the temperature $\tau$ add another sort of randomness in the generation process. It affects the shape of the probability distribution. 
The probability distribution is formulated as follows:</p>

\[\text{softmax}(x_i) = \frac{e^{\frac{x_i}{\tau}}}{\sum_{j} e^{\frac{x_j}{\tau}}}\]

<p>So, higher temperature encourages the probability distribution to be near to a uniform distribution. This is why higher temperature lead to hallucination. Lower temperature increases the probability of the most probable tokens and decreases the probability of unlikely tokens.</p>

<p>If we use top-k sampling strategy with lower temperature, we will likely sample the same sequence if we call the LLM many times.</p>

<p><strong>Nucleus sampling strategy</strong>: known also as top-p sampling. At each timestep $t$, it consists of selecting top probable tokens in a descending way until their cumulitive probabilities exceeds a cutoff values $p$. Then, the next token is sampled from the selected tokens. Using this strategy, we have at each timestep $t$ a different number of tokens to select from. This encourages more diverse and creative output.</p>

<h2 id="quantization">Quantization:</h2>

<p>Large Language Models require powerful resources to generate a response in a reasonable time as they get bigger and have more parameters. Not only the number of parameters that influences the quantity of computational resources needed, but also the data type of the parameters affects and the efficiency of the model. Generally in deep learning, and in LLMs specifically, FP32, FP16 and BF16 are used as data types:</p>
<ul>
  <li><strong>FP32:</strong> Uses 32 bits to represent a number. One for the the sign, eight for the exponent, and the remaining for the significand. This data type provide a high degree of precision but it is computational high and memory footprint.</li>
  <li><strong>FP16:</strong> Uses 16 bits to represent a number. One bit for the sign, five for the exponent and 10 for the significand. It is more memory efficient and less computational but it introduce numerical stability and potentially impact the model performance due to the reduced range and precision in representing the number.</li>
  <li><strong>BF16:</strong> Uses also 16 bits to represent a number. One for the sign, seven for the exponent and 8 for the significand. It expands the representable range compared to FP16, thus decreasing underflow andoverflow risks. Despite a reduction in precision due to fewer significand bits, BF16 typically does not significantly impact the model performance.</li>
</ul>

<p>As you can conclude, using 1B model with FP32 or FP16 will come with a tradoff between accuracy and memory footprint and latency. Depending on the use case, we can have the accuracy needed with data types that are computational lower than FP16, such as INT8 or INT4. The model parameters (weights) are generally in FP32 and converting them to a lower-precision data type such as INT8 or INT4 is called <strong>Quantization</strong>.</p>

<p>Generally, we have two types of Quantization:</p>
<ul>
  <li>Post-Training Quantization (PTQ): It is straightforward technique where the weights of an already trained model are converted to a lower-precision data type.</li>
  <li>Quantization-aware training (QAT): incorporate the quantization process during training stage of finetuning. QAT is computational expensive and requires representative training data.</li>
</ul>

<p>Let’s get an intuition by introducting some naive-quantization 8-bit techniques.</p>

<p><strong>Absolute Maximum Quantization (absmax):</strong> It uses the following formula to convert an FP32/FP16 number to INT8 number:</p>

\[X_{quant} = round(\frac{127}{|{X}|}.X)\]

\[X_{dequant} = round(\frac{max(|{X}|)}{127}.X_{quant})\]

<p>This methods is symetric and it maps weights values to a range of $[-127, 127]$</p>

<p>This methods comes with a loss of precision due to rounding. When applying the dequantization formula to get the original weights, we will have a precision error.</p>

<p><strong>Zero-Point Quantization:</strong> It applies the following formula to perform quantization.</p>

\[scale = \frac{255}{max(X) - min(X)}\]

\[zeropoint = -round(scale . min(X)) - 128\]

\[X_{quant} = round(scale . X + zeropoint)\]

\[X_{dequant} = \frac{X_{quant} - zeropoint}{scale}\]

<p>This methods is asymetric and maps the weights value to a range of $[-128, 127]$</p>

<p>In practice, we apply vector-wise quantization which consider the variability of values in rows and columns of the same Tensor. Quantizing the entire Tensor in one pass will lead to a huge model degradation and quantizing individual values will yield to a big computation overhead.</p>

<p>The both methods discussed above are sensitive to outliers.</p>]]></content><author><name>Rida Lefdali</name></author><category term="Technical-post" /><summary type="html"><![CDATA[Hi, in this blog, I will try to give an overview about LLMs stacks that can help you to land on any project requiring LLMs. I will go from core component of each LLM architecture, passing by how inference is done in LLMs. Then I will talk about finetuning LLMs on your own dataset or for your own tasks. This post will be updated on a regular basis until it covers all possible aspect of LLMs]]></summary></entry><entry><title type="html">RAG System Overview</title><link href="https://lefdrida.github.io/posts/2025/RAG_Blog/" rel="alternate" type="text/html" title="RAG System Overview" /><published>2025-01-20T15:12:00+00:00</published><updated>2025-01-20T15:12:00+00:00</updated><id>https://lefdrida.github.io/posts/2025/RAG_Blog</id><content type="html" xml:base="https://lefdrida.github.io/posts/2025/RAG_Blog/"><![CDATA[<h2 id="retrieval-augmented-generation">Retrieval Augmented Generation</h2>

<p>LLMs such as GPT family, Llama, Qwen or deepseek … are trained on large data that is gathered mainly by crawling the internet. This step of training on large data is called pretraining which is very costly. For example llama 3 with 1 billion parameters requires 314k GPU hour of H100 with 80GB. The knowledge of these LLMs is constrained by the website crawled (i.e data trained on) and time of crawling. This means when asking these LLMs about information that are resticted, for example companies internal documents or information that are occured after the crawling time, they will fail to answer correctly i.e they will hallucinates. Addressing these challenge is very crucial for LLMs to be more valuable, especially within companies.</p>

<p>We can think of updating LLMs with new information by fine-tuning them using full fine-tuning or techniques such as LoRA. But fine-tuning has also a cost. Imagine an Investor needs to have a summary of news everyday about differents topics e.g politics, finance, regulations and technology and within different countries. For this scenario when the data is updated on a regular basis, finetuning is not practical. To overcome this challenge, Retrieval Augmented Generation tend to be a suitable solution. Retrieval Augmented Generation take advantage of the ability of LLMs to understand the information provided within the prompt, called “context”, and mix it with retrieval techniques which provides information similar to the query from an external database.</p>

<h2 id="rag-framework">RAG Framework</h2>

<h2 id="basic-rag-workflow">Basic RAG Workflow</h2>]]></content><author><name>Rida Lefdali</name></author><category term="Technical-post" /><summary type="html"><![CDATA[Retrieval Augmented Generation]]></summary></entry><entry><title type="html">Math_you_need_as_ds</title><link href="https://lefdrida.github.io/posts/2025/math_you_need_as_ds/" rel="alternate" type="text/html" title="Math_you_need_as_ds" /><published>2025-01-20T00:00:00+00:00</published><updated>2025-01-20T00:00:00+00:00</updated><id>https://lefdrida.github.io/posts/2025/math_you_need_as_ds</id><content type="html" xml:base="https://lefdrida.github.io/posts/2025/math_you_need_as_ds/"><![CDATA[<hr />
<p>layout: distill
title: LLM From Scratch
date: 2025-01-20 11:12:00-0400
description: 
tags: 
categories: Technical-post
related_posts: false
giscus_comments: true
featured: true
mermaid:
  enabled: true
  zoomable: true
code_diff: true
map: true
chart:
  chartjs: true
  echarts: true
  vega_lite: true
tikzjax: true
typograms: true</p>

<p>authors:</p>
<ul>
  <li>name: Rida Lefdali
url: “www.linkedin.com/in/rlefdali/”
affiliations:
  name: Independent
toc:</li>
  <li>name: Math</li>
  <li>name: Probability, Statistics, Algebrea.</li>
</ul>

<p>_styles: &gt;
  .fake-img {
    background: #bbb;
    border: 1px solid rgba(0, 0, 0, 0.1);
    box-shadow: 0 0px 4px rgba(0, 0, 0, 0.1);
    margin-bottom: 12px;
  }
  .fake-img p {
    font-family: monospace;
    color: white;
    text-align: left;
    margin: 12px 0;
    text-align: center;
    font-size: 16px;
  }</p>]]></content><author><name>Rida Lefdali</name></author><summary type="html"><![CDATA[layout: distill title: LLM From Scratch date: 2025-01-20 11:12:00-0400 description: tags: categories: Technical-post related_posts: false giscus_comments: true featured: true mermaid: enabled: true zoomable: true code_diff: true map: true chart: chartjs: true echarts: true vega_lite: true tikzjax: true typograms: true]]></summary></entry><entry><title type="html">Energy Forecasting with LSTM</title><link href="https://lefdrida.github.io/posts/2025/LSTM_times_series_pred/" rel="alternate" type="text/html" title="Energy Forecasting with LSTM" /><published>2025-01-18T15:12:00+00:00</published><updated>2025-01-18T15:12:00+00:00</updated><id>https://lefdrida.github.io/posts/2025/LSTM_times_series_pred</id><content type="html" xml:base="https://lefdrida.github.io/posts/2025/LSTM_times_series_pred/"><![CDATA[<h2 id="introduction">Introduction</h2>

<p>In this post we will cover LSTM through time series forecasting. The aim is to explain LSTM and its advantage regarding RNNs. We will cover an application of Energy consumption and cover also some statistical algorithm for comparison.</p>

<p>As we explained previously RNN takes as input a sequence of elements and outputs a sequece of hidden states. Each unit in RNN take as input an element from sequence and the hidden state of the previous element from the sequence. 
Dealing with sequences makes RNN suitable for making prediction using time series as data. Time series is a sequence of elements, that could be real value, images or texts, that is ordered in a chronological order.</p>

<p>A first problem of RNN is its inability to perform well on tasks that require the use of information distant from the current point of procssing. The hidden states tends to be local and relevant only the most recent parts of the input sequence. The second problem is vanishing gradients, as during training the error needs to backpropagate through time and then we have repeated multiplications which results in that gradients are eventualy driven to zero.</p>

<p>To address this limitations, more complex network was designed. And LSTM is the most commonly used as an extension to RNN.</p>

<h2 id="long-short-term-memory-lstm">Long Short Term Memory LSTM</h2>

<p>Long Short term memory solves the limitation of neglicting information distant from the current time step, encountered in RNN. It achieves this by adding a context layer to the architecture that output a context vector \(c_t\). And, adding, also, gates that allow either to remove information that are no longer needed or to add information to be needed for later decision making.</p>

<p>The first gate to consider is the <em>forget gate</em> \(f_t\). Its purpose is to delete information that are no longer needed and computed as follows:</p>

\[f_t = \sigma (U_f h_{t-1} + W_fx_t)\]

\[k_t = c_t \odot f_t\]

<p>The second gate to consider is the <em>add gate</em> which aims to select information to add to the current context and computed as follows:</p>

\[i_t = \sigma (U_i h_{t-1} + W_i x_t)\]

\[j_t = g_t \odot i_t\]

<p>where \(g_t\) is the actual information we need to extract from the previous hidden state and current input :</p>

\[g_t = tanh (U_g h_{t-1} + W_g x_t)\]

<p>the output of the add gate and the forget gate are summed then to get the current context vector:</p>

\[c_t = j_t + k_t\]

<p>finally we have the output gate that decides what information is required for the current hidden state. Is is computed as follows:</p>

\[o_t = \sigma (U_o h_{t-1} + W_o x_t)\]

\[h_t = o_t \odot tanh(c_t)\]

<p>We can remark that the gates have a similar design. They contain a feedforward layer, followed by a sigmoid function, and finally followed by an element-wise multiplication with the layer being gated.<br />
The choice of <em>sigmoid</em> function arises from its tendency to push its output to either 0 or 1. With the use of the element-wise multiplication, we have the effect of a binary mask. This allows then the values in the layer being gated that align with values near to 1 to pass and the values that align vaues near 0 to be erased. This makes the intuition behind how the add gate or the forget gate select or delete information.</p>

<p>The LSTM can be implemented using Pytorch simply as follows:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">torch</span>
<span class="n">lstm</span> <span class="o">=</span> <span class="n">nn</span><span class="p">.</span><span class="nc">LSTM</span><span class="p">(</span>
            <span class="n">input_size</span><span class="o">=</span><span class="n">d</span><span class="p">,</span> <span class="c1"># The size of the input
</span>            <span class="n">hidden_size</span><span class="o">=</span><span class="n">n_units</span><span class="p">,</span> <span class="c1"># The size of the hidden state 
</span>            <span class="n">num_layers</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span>
            <span class="n">bias</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
            <span class="n">batch_first</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
            <span class="n">bidirectional</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span>
        <span class="p">)</span>
</code></pre></div></div>

<p>to be continued …</p>]]></content><author><name>Rida Lefdali</name></author><category term="Technical-post," /><category term="ML" /><summary type="html"><![CDATA[Introduction]]></summary></entry></feed>